HEROZ Tech Blog

日本将棋連盟公認「将棋ウォーズ」や、AIを活用したシステム企画・開発を行う、AI企業HEROZの公式テックブログです。

AIエージェントはLinux障害調査を完遂できるか ~ReadOnlyな専用ツールで検証した自律調査PoC

はじめに

多数のLinuxサーバーを運用していると、障害発生時の一次調査が大きな負担になります。

担当者は対象へ接続し、ログや設定ファイルを探し、プロセスやポート、ディスク、メモリなどを確認します。原因の見当がついた後には、調べた内容と根拠を整理し、次の判断をする人へ引き渡さなければなりません。

個々の操作はそれほど複雑でなくても、何をどの順番で調べるかは障害ごとに異なります。調査対象や案件数が増えるほど、こうした一次調査に使う時間も増えていきます。

そこで考えたのが、AIエージェントへ障害の一次調査を任せられないか、ということです。

利用者から曖昧な障害申告を受け取り、仮説を立て、複数のツールで状況を確認し、必要なら仮説を修正しながら、最後は調査レポートまで作る。将来的により長時間・多段階の調査へ発展させることを考えると、AIエージェントと相性のよさそうな仕事に見えます。

一方で、Linux環境へ接続するAIエージェントに任意のシェルコマンドを渡すのは、かなり怖い設計でもあります。

結論から言うと、今回のPoCでは、任意コマンドを与えずReadOnlyの専用ツールだけに制限しても、AIエージェントが障害に関係する証跡を集め、人間が次の判断を行えるレポートまで作成できました。

実際に試してみると、探索をどこまで続けるか、複数の異常から何を重要視するかといった「調べ方」には条件ごとの違いも見えてきました。

障害調査の何をAIへ任せるのか

今回のPoCでは、AIに障害対応そのものを任せるのではなく、一次調査と証跡整理をどこまで任せられるかに焦点を絞りました。

「原因を当てる」ことを目的にしなかった

障害調査AIというと、障害の原因を自動的に特定するシステムを想像するかもしれません。

しかし、実際の障害調査では、最初から完全な原因へ到達できるとは限りません。利用者から伝えられる情報も、「サーバが重い」「設定変更後から通信できない」といった曖昧な内容であることがあります。

そのような状況で、AIが根拠の薄い原因を断定しても、担当者の助けにはなりません。

そこで今回は、原因の完全な特定よりも、次の状態まで調査を進めることを重視しました。

  • 障害に関係するファイルやログを発見する
  • プロセス、ポート、ディスク、メモリなどの状態を確認する
  • 人間が原因判断に使える証跡を収集する
  • 事実、推定、未確認事項を分離する
  • 根拠付きの調査レポートとしてまとめる

つまり、今回の「調査完遂」は、正解を一発で当てることではありません。

人間が次の判断を行えるだけの証跡を集め、調査結果をレポートとして引き渡すこと

と定義しました。

長時間実行を見据えた基礎検証

今回のシナリオ自体は、数分から十数分程度で終了する基礎的なものです。何時間も動き続けるエージェントを検証したわけではありません。

まず確認したかったのは、曖昧な申告だけを起点に、自律的に調査を開始し、複数の調査手段を使い分け、必要に応じて追加確認を行いながら、レポート作成まで到達できるかという点です。

実業務では、対象となるログや設定はさらに増え、過去情報や複数の機器を横断して調べる可能性もあります。その前段として、まずは小さく切り出したLinux環境で検証しました。

任意コマンドを渡さず、できることを制限する

AIエージェントにLinuxを調査させるだけなら、シェルを渡して自由にコマンドを実行させるのが最も簡単です。

今回はあえてその方法を取りませんでした。

ReadOnlyの専用ツールへ分解する

シェルを使えば、psssdfgrepなどを柔軟に組み合わせられます。一方、同じ経路からサービス停止、ファイル変更、パッケージ導入、外部通信なども実行できます。

「調査だけを行い、変更はしないでください」とプロンプトに書くことはできますが、それだけを安全性の根拠にはしたくありません。

そこで今回は、任意コマンドやスクリプトを受け取る機能を公開せず、調査に必要な操作を専用ツールへ分解しました。

ファイルの一覧・検索・読み取り、プロセスやListenポートの確認、ディスクやメモリの状態取得など、用途の決まったReadOnly操作だけを提供します。サービス状態やjournalについても専用ツールを用意し、対象環境で利用できない場合は、その理由を返す設計にしました。

SSH側でも任意の文字列をそのままコマンドとして実行するのではなく、固定された処理からコマンドを生成します。sudo権限を持たないユーザーを使い、アクセス可能なパスや実行時間、取得件数、出力量にも上限を設けました。

ここで重要なのは、モデルへ「変更しないでください」とお願いするのではなく、変更できる道具を最初から渡さなかったことです。

Skillは調査方法、ツールは能力境界

モデルへは、ツールとは別に障害調査用のSkillも与えました。

役割を整理すると次のようになります。

主な役割
モデル 状況を解釈し、次に何を確認するか考える
Skill 調査の進め方、証拠の扱い、レポート形式を規定する
MCPツール 実行できる操作をReadOnlyの範囲へ限定する
SSH・OS権限 実際にアクセスできるリソースを限定する

Skillでは、事実・推定・未確認事項を分けることや、権限不足や取得上限を「証拠がなかった」と混同しないこと、根拠が不足している場合は断定しないことなどを定めています。

つまり、Skillはどう調査してほしいかを整える仕組みです。一方、ツールとOS権限は実際に何ができるかを制限します。

Skillへの指示自体をセキュリティ境界とは考えていません。

最近のAIエージェント事例から見た権限境界

今回の検証と前後して、AIエージェントが設計者の想定を超えて行動した事例が相次いで公表されました。

Anthropicはエージェントの封じ込めに関する記事で、Claudeがタスクを完遂するためにサンドボックスを抜けた事例などを紹介し、モデルの振る舞いを監督するだけでなく、サンドボックスやファイルシステム境界、外向き通信の制御によって「そもそも何ができるか」を制限する考え方を説明しています。

2026年7月には、Hugging Faceによる先行開示を受けて、OpenAIがモデル評価中に発生したセキュリティインシデントを公表しました。評価中のモデルは未知の脆弱性や認証情報などを組み合わせ、評価環境の外へ到達してHugging Faceの本番インフラへアクセスしました。

さらに、Anthropicも7月30日に3件の実システムへの不正アクセスを公表しています。こちらはOpenAIの事例とは性質が異なり、評価環境に意図せずインターネット接続が残っていたことが主な要因でした。8月にはMetaの評価でも、設定不備によってインターネットへ到達したモデルが第三者サービスの脆弱性を利用した事例が報じられています。

これらを単純に「AIが脱獄した」と一括りにすることはできません。それでも共通して見えるのは、モデルへ「ここから先はやらない」と伝えることと、システムとして「ここから先はできない」状態にすることは別物であるという点です。

今回ReadOnlyの専用ツールへ操作を分解したのも、後者の境界を明確にするためです。

もちろん、ReadOnlyであればすべて安全というわけでもありません。対象システムの変更は防げても、読み取った設定やログに機密情報が含まれる可能性は残ります。また、ログや設定に埋め込まれた命令による間接プロンプトインジェクションも、今回は検証していません。

ReadOnlyは万能な安全策ではなく、エージェントが誤動作した場合の影響範囲を小さくするための一つの境界として位置付けています。

5つの疑似障害で検証した

ここからは、実験条件と評価方法をまとめて説明します。後から条件を補足するのではなく、以下を今回のPoCの前提としています。

実験条件

項目 条件
調査対象 Rocky Linux 9互換のDockerターゲット 1台
接続経路 Claude Desktop → ローカルMCP Server → SSH
操作範囲 任意コマンドを提供せず、ReadOnlyの専用ツールのみ使用
ケース間の分離 シナリオごとにコンテナを再作成
容量不足の再現 サイズ制限付きtmpfsを使用
メモリ関連の証跡 高RSSプロセス、cgroup使用量・上限など
systemd / journald 実機相当の完全な再現は対象外。ツールから利用できない場合はその理由を返す
AIへの入力 利用者から見える事象のみ。Ground Truthや期待証跡は与えない
比較条件 Sonnet 5(推論:中)、Opus 5(推論:高)
試行回数 原則1回。Sonnet 5のcase03のみ2回
レポート 事実・推定・未確認事項を分離し、調査概要、収集した証跡、根拠、追加確認・対応候補として出力
対象外 間欠障害、複数ノード、複数原因が同時に存在する障害
コスト トークン消費量・API料金は今回の評価対象外

Dockerターゲットはシナリオごとに再作成し、容量不足用のtmpfsが別ケースへ影響しないようにしています。また、systemd/journaldを完全に再現するための特権コンテナは今回の対象外です。

モデルと推論設定が同時に異なるため、以下の結果はモデルそのもののランキングではなく、今回の2条件で観察された調査行動の違いとして扱います。

テストシナリオ

原因と期待証跡を事前に定義しやすい、5つの基本的なLinux障害を用意しました。

ケース 利用者へ伝える事象 想定した原因
01 Webサイトへ接続できない nginx停止
02 サービスが正常動作しない データ領域の容量不足
03 サーバが重い メモリ使用量増大
04 設定変更後から通信できない 設定ファイルの誤記
05 アプリケーションエラーが発生する バックエンド接続エラー

各ケースでは、AIへは利用者から見える事象だけを渡します。Ground Truthや期待証跡はホスト側だけに保持し、調査対象から直接読み取れないようにしました。

実運用をそのまま再現するのではなく、まずは原因と期待証跡を事前に定義できる基礎ケースに絞っています。

評価ルール

原因を当てたかだけではなく、人間が判断に使える証跡を集められたかを重視しました。

項目 ルール
証跡成功 シナリオごとに定義した最低限の証跡を取得し、調査レポートを生成できた
総合通過 証跡成功に加え、想定原因が原因候補に含まれ、10分以内に完了した
目標時間 一次調査として10分以内
case03の集計 Sonnet 5のみ2試行。ケース単位の成功判定では成功した試行を採用し、平均時間では2試行の平均を使用

たとえばcase02では、実際のデータ保存先、その保存先が属するファイルシステムの使用状況、容量不足を示すエラーログなどを必須証跡としました。ケースごとの必須証跡は、事前に定義したうえで評価しています。

結果:この条件では「調べ方の癖」が分かれた

結果の概要は次のとおりです。

指標 Sonnet 5
(推論:中)
Opus 5
(推論:高)
証跡成功・ケース単位 4/5ケース 5/5ケース
総合通過・ケース単位 4/5ケース 4/5ケース
ケース均等平均時間 4分14秒 6分47秒
成功件数:5ケース=100% / 平均時間:10分=100%

2条件の証跡成功・総合通過・平均所要時間

Sonnet 5のcase03のみ2試行しているため、上表の成功判定と平均時間は、前節の評価ルールに従って集計しています。元の試行データでは、Sonnetは6試行中4試行で証跡成功、Opusは5試行すべてで証跡成功でした。

なおcase05については、検証後に評価用fixture側の定義に見直すべき点が見つかっています。表は事前に定義した基準どおり集計していますが、この1ケースの判定には留保があります。

Opus条件では5ケースすべてで必要な証跡を回収できました。一方、case03では10分46秒を要したため、10分以内という条件を含む総合通過は4/5ケースとなりました。

Sonnet条件では、原因が明確なケースでは短時間で必要な証跡まで到達しましたが、曖昧な申告から調査を始めたcase02では探索を早く収束させ、必要な証跡を取り逃がしました。

またOpus条件も、すべてのケースで想定原因を最重要候補にできたわけではありません。case02とcase03では複数の異常を広く拾った結果、利用者が申告した事象との関係が弱い問題を上位に置きました。

今回の結果から見えてきたのは、単純な能力の上下というより、

  • 早く仮説を絞るが、探索を打ち切りすぎることがある
  • 広く探索できるが、発見した異常の優先順位付けに迷うことがある

という調査行動の違いです。

一つの正常値で調査を終えない

調べ方の違いが最も分かりやすく表れたのがcase02でした。

利用者からの申告は「サービスが正常動作しない」で、実際の原因はアプリケーションのデータ保存領域の容量不足です。

Sonnet条件では、まずルートファイルシステムの使用率を確認しました。そこには十分な空きがあったため、容量不足の可能性を下げ、別の原因へ調査を進めました。

しかし、実際のデータ保存先は独立したファイルシステムにありました。Sonnetは保存先を示す設定、そのファイルシステムの使用状況、書き込み失敗ログを取得できていませんでした。

一方、Opus条件では設定から実際の保存先をたどり、そのファイルシステムの状態とNo space left on deviceのログまで確認できました。

ここで問題だったのは、ディスク使用率を確認しなかったことではありません。正常な値を一つ見つけたことで、容量不足という仮説そのものを早く捨ててしまったことです。

障害調査では、「一般的にどこを見るか」だけでなく、設定から実際のデータフローを追う必要があります。

こうした失敗は、モデルを交換するだけでなく、

データ保存先や接続先は設定から確認し、その実体の状態まで追う

といった探索ルールをSkillへ戻すことで改善できる可能性があります。

またcase03では、同じSonnet 5・同じ推論設定で2回実行したところ、1回目は必須証跡4項目のうち2項目しか取得できなかった一方、2回目は4項目すべてを取得できました。同じ条件でも調査結果が変わったため、実業務へ進む際には単発の成功だけでなく再現性を見る必要があります。

今回のPoCで特に収穫だったのは、モデルの勝敗そのものより、どこで探索を打ち切りやすいか、何を見落としやすいかを具体的に観察できたことでした。

PoCとして何が分かったか

今回確認したかったのは、「Linux障害を完全自動診断できるか」ではありません。

冒頭で定義した通り、人間が次の判断を行えるだけの証跡を集め、レポートとして引き渡せるかを検証しました。

その観点では、任意コマンドを使わずReadOnlyのツールだけで自律調査を進め、基本的なLinux障害について必要な証跡を集め、根拠を整理したレポートまで生成できました。

基礎的なPoCとしては成立したと考えています。

同時に、探索の早期収束、複数の異常を発見したときの順位付け、試行ごとの再現性といった課題も見えました。

これは「より性能の高いモデルを使えば終わり」という種類の問題ではなさそうです。モデルが失敗した調査経路を観察し、Skillの探索手順や完了条件へフィードバックしていくことも重要になります。

まとめ

今回は、Linux障害の一次調査を省力化することを目指し、任意コマンドを与えずReadOnlyの専用ツールだけを使うAIエージェントを試しました。

5つの基本的な疑似障害では、限定されたツールだけでも、AIエージェントが証跡を収集し、レポートまで調査を進められることを確認できました。

一方、今回の条件では、Sonnet 5(推論:中)は短時間で調査を進める反面、探索を早く収束させるケースがありました。Opus 5(推論:高)は証跡を広く回収する一方、時間や原因候補の優先順位付けに課題がありました。

AIエージェントを障害調査へ使う際に重要なのは、モデルへすべてを任せることではなく、

どのように調べるかをSkillで整え、何ができるかをツールとOS権限で制限すること

だと考えています。

目指しているのも、AIが障害解析担当者を完全に置き換えることではありません。

時間のかかる一次調査と証跡整理をAIエージェントへ任せ、人間が原因判断や対応方針の決定に集中できる状態です。

今回の検証は基本的なLinux障害を対象にした第一歩です。今後は、より実運用に近いログや設定、長時間の調査、複数回実行したときの再現性などへ対象を広げながら、実際の障害調査フローにつなげていきたいと考えています。
Whisperはまだ第一候補なのか?最新OSSとOpenAI Transcribe APIを日本語音声で比較してみた

はじめに

日本語の音声認識では、長らくWhisperが有力な選択肢でした。OpenAIが2022年に公開して以降、ローカルで利用できる高精度なASRモデルとして広く使われています。

一方、最近ではCohere TranscribeNVIDIA ParakeetQwen3-ASRなど、日本語に対応した新しいOSSモデルも登場しています。

OpenAIからも、gpt-transcribegpt-4o-transcribegpt-4o-mini-transcribeと複数の文字起こしAPIが提供されています。

こうなると、既存システムでWhisperを使い続けるべきなのか、新しいOSSへ切り替えるべきなのか、あるいはAPIを利用した方がよいのかが気になります。

そこで今回は、Whisper系列、新しいOSS、日本語対応のOpenAI Transcribe APIを、3種類の日本語公開データセットで比較しました。

結論から言うと、Whisperは読み上げ音声ではまだ十分競争力があります。一方、精度を理由にこれからWhisperを新規採用したり、Fine-tuningへ進んだりするのであれば、その前にCohere Transcribeなど新しい基盤モデルを同じデータで比較しておいた方がよい、という結果になりました。

単純に「新しいモデルほど強い」という結果にはならなかった点も、今回興味深かったところです。

先行する日本語ASR比較

日本語ASRについては、すでに有用な比較結果が公開されています。

Neosophieでは、自然会話を含む音声を使って複数の日本語ASRモデルを比較しています。

neosophie.com

また、ASR_ja_comparisonではFLEURS Japaneseを使った比較が公開されています。

github.com

今回の目的は、これらの結果と順位を競うことではありません。

評価音声やモデルのバージョンが異なれば結果も変わります。そこで今回は、性格の異なる3種類の公開データセットを同じ評価パイプラインへ通したときに、モデルごとの傾向がどの程度変わるのかを見ることにしました。

評価方法

評価データ

以下の3種類の公開データセットを使用しました。

データセット 発話数 今回の位置づけ
FLEURS Japanese 46 標準的な読み上げ音声
Common Voice Japanese 26.0 127 話者・録音環境のばらつきがある音声
JSUT basic5000 132 高品質な日本語読み上げ音声

Common VoiceにはMozilla Data Collectiveで配布されているJapanese Scripted Speech 26.0のtest.tsvを使用しました。

JSUTは約10時間の単一話者日本語音声コーパスで、今回はそのうちbasic5000サブセットを使用しています。

各データセットについて、seed 42で発話をシャッフルし、0.2秒以上30秒以下の音声を対象に、累積音声時間が約10分になるまで発話単位で抽出しました。音声は16kHz・monoのPCM WAVへ統一しています。

評価指標

文字起こし精度にはCER(Character Error Rate)を使用しました。

各発話について、正解文と文字起こし結果を正規化したうえでLevenshtein距離からCERを算出し、データセット全体の値には各発話CERの単純平均(macro average)を使用しています。 そのため、micro averageで集計された他の公開ベンチマーク値とは、CERの絶対値を直接比較できません。

正規化では、以下を行いました。

  • Unicode NFKC
  • 英字の小文字化
  • 空白の除去
  • 句読点の除去
  • 記号の除去

数字表記の変換や、漢字・ひらがな・カタカナ間の変換、読み仮名化などは行っていません。

日本語では同じ内容でも表記が異なる場合があるため、CERだけで認識品質を完全に評価できるわけではありません。今回はすべてのモデルを同じ正規化条件で比較しています。

また、各評価セットは約10分と小規模なので、特に1ポイント未満の差については厳密な順位ではなく、傾向として見ることにします。

OSSモデルではRTF(Real Time Factor)も確認しました。

RTFはモデルロードを除き、音声ファイルの読み込みから文字起こし結果を得るまでの処理時間を音声時間で割った値です。たとえばRTF 0.1であれば、10秒の音声を約1秒で処理したことになります。値が小さいほど高速です。

VRAMはモデルロード前後のnvidia-smiによるGPU使用量差を記録しました。推論中のpeak値ではないため、今回の実行条件における参考値として扱います。

OSSモデルはNVIDIA A100上で、1発話ずつ処理しました。Fine-tuning、Prompt、用語リスト、量子化は使用していません。

評価したモデル

今回は以下の11モデルを比較しました。

モデル 実モデルID 種別
whisper-large-v3 openai/whisper-large-v3 OSS
whisper-large-v3-turbo openai/whisper-large-v3-turbo OSS
kotoba-whisper-v2 kotoba-tech/kotoba-whisper-v2.0 OSS
qwen3-asr-0.6b Qwen/Qwen3-ASR-0.6B-hf OSS
qwen3-asr-1.7b Qwen/Qwen3-ASR-1.7B-hf OSS
reazon-zipformer reazon-research/japanese-zipformer-base-k2-rs35kh OSS
cohere-transcribe CohereLabs/cohere-transcribe-03-2026 OSS
parakeet-ja nvidia/parakeet-tdt_ctc-0.6b-ja OSS
openai-gpt-transcribe gpt-transcribe API
openai-gpt-4o-transcribe gpt-4o-transcribe API
openai-gpt-4o-mini-transcribe gpt-4o-mini-transcribe API

Whisper系列では日本語とtranscribeを明示指定し、Qwen3-ASRやCohereでも対応する日本語指定を行っています。

APIモデルについても1音声ずつ送信し、日本語を指定しています。

今回は基礎的な文字起こし性能を見ることを優先し、API料金を含むTCO比較やタイムスタンプ機能の比較は行っていません。

結果

CER

まず、3データセットでのCERです。

モデル FLEURS
CER
Common Voice
CER
JSUT
CER
whisper-large-v3 4.24% 28.61% 7.01%
whisper-large-v3-turbo 3.88% 75.55%※ 7.22%
kotoba-whisper-v2 5.88% 26.62% 7.36%
qwen3-asr-0.6b 8.44% 34.12% 11.90%
qwen3-asr-1.7b 5.28% 26.33% 8.42%
reazon-zipformer 12.31% 28.32% 9.54%
cohere-transcribe 2.89% 20.22% 8.59%
parakeet-ja 5.56% 21.53% 6.60%
openai-gpt-transcribe 4.38% 23.26% 6.54%
openai-gpt-4o-transcribe 2.26% 26.25% 5.14%
openai-gpt-4o-mini-transcribe 4.11% 27.16% 6.57%

3つの日本語データセットにおけるCER。値が小さいほど高精度。

今回の結果で最も注目したのはCohere Transcribeです。FLEURSとCommon VoiceではWhisper large-v3より低いCERとなり、Common Voiceでは今回の11モデル中で最も低い値でした。

一方、OpenAIのAPIではgpt-4o-transcribeがFLEURSではCohere Transcribeと並んで低い水準となり、JSUTでは最も低いCERとなりました。データセットによって上位モデルは変わっています。

※ Whisper large-v3-turboのCommon Voiceでは、1件の発話で同じフレーズを大量に繰り返す出力が発生し、その発話のCERが5,525%となりました。CERは発話単位の単純平均で集計しているため、この1件の影響を強く受けています。異常値として除外せず、そのまま結果に含めています。

Cohere TranscribeはWhisperの有力な比較対象になった

今回、Whisperからの移行候補として最も気になったのはCohere Transcribeです。

Whisper large-v3と比較すると、

  • FLEURS:4.24% → 2.89%
  • Common Voice:28.61% → 20.22%
  • JSUT:7.01% → 8.59%

となりました。

3データセットすべてでWhisperを上回ったわけではありませんが、FLEURSとCommon Voiceでは低いCERとなっています。

特にCommon Voiceでは、今回評価した11モデルの中で最も低い値でした。

一方、JSUTではWhisper large-v3の方が低いCERです。

そのため、「Cohereへ置き換えれば常に精度が上がる」とまでは言えません。それでも、これからWhisperを精度目的で新規採用したり、WhisperのFine-tuningへ進んだりするのであれば、まず同じ業務音声をCohere Transcribeへ通して比較する価値は高いと考えています。

なお、今回の検証ではタイムスタンプ機能など、文字起こし以外の機能要件は比較していません。実際の置き換え可否は、こうした機能要件も含めて判断する必要があります。

OSSモデルのRTFとVRAM

次にOSSモデルのRTFとVRAMを見ます。 なお、表のRTFは3データセットで観測した値の範囲です。

モデル RTF VRAM
(MB)
whisper-large-v3 0.15〜0.23 3,611
whisper-large-v3-turbo 0.04〜0.09 1,658
kotoba-whisper-v2 0.03〜0.08 1,550
qwen3-asr-0.6b 0.10〜0.17 1,492
qwen3-asr-1.7b 0.10〜0.17 3,886
reazon-zipformer 0.01〜0.02 816
cohere-transcribe 0.04〜0.09 4,266
parakeet-ja 0.01〜0.03 5,328

OSSモデルのRTFとVRAM使用量。RTFは小さいほど高速。VRAMは今回の実行条件における参考値。

Parakeet JAはRTF 0.01〜0.03と、今回評価したOSSの中でも高速でした。Common VoiceとJSUTでは比較的低いCERでしたが、FLEURSではCohere TranscribeやWhisper large-v3より高いCERとなっています。

このため、今回の範囲では「一貫して高精度なモデル」というより、処理速度を重視する場合に気になる選択肢という位置づけです。

なお、VRAMはモデルロード前後のGPU使用量差であり、今回の実行条件における参考値です。

Whisperをすぐ置き換える必要はない

Whisper large-v3はFLEURSで4.24%、JSUTで7.01%となり、読み上げ主体の音声ではまだ十分競争力があります。一方、Common VoiceではCohere TranscribeやParakeet JAより高いCERとなりました。

そのため、既存のWhisperシステムを精度差だけで急いで置き換える必要はないと考えています。

ただし、新規にWhisperを採用する場合や、Fine-tuningへ追加投資する場合は別です。その前に、Cohere Transcribeをはじめとする新しい基盤モデルでベースラインを取り直す方が先でしょう。

先行比較と見比べて分かったこと

今回と先行比較では、上位モデルが必ずしも一致しませんでした。

自然会話を含む別の公開比較ではQwen3-ASRやWhisper系列が良い結果を示しています。一方、今回のFLEURSやJSUTは読み上げ音声が中心で、Common Voiceも話者や録音環境にはばらつきがあるものの、自然会話とは性格が異なります。

実際の業務音声では、複数話者、言い淀み、発話の重なり、背景雑音、専門用語など別の難しさがあります。

したがって、公開ベンチマークの順位をそのまま採用判断に使うのではなく、最終的には実際の用途に近い音声で比較する必要があります。

まとめ

今回は、Whisper系列、新しいOSS ASR、OpenAI Transcribe APIの計11モデルを、3種類の日本語公開音声で比較しました。

今回の検証で一番大きかったのは、Whisperを前提として改善を続ける前に、Cohere Transcribeを含む新しい基盤モデルで一度ベースラインを取り直した方がよいと確認できたことです。

既存のWhisperシステムをすぐに置き換える必要はありません。一方、これからWhisperを新規採用したり、Fine-tuningへ進んだりするのであれば、その投資の前に新しいモデルへそのまま置き換えて、同じ業務音声でどこまで出るかを見る。

ASRでも、この順序で検討するのがよさそうです。

AIエージェントの「ハーネス」とは何か:Cowork時代の事務作業エージェントを3問だけ試して見えたこと

はじめに

最近、AIエージェントという言葉を聞く機会が増えました。

エンジニア向けには、Codex CLI、Claude Code、Gemini CLI のようなコーディングエージェントが広がっています。一方で、最近はこの流れがエンジニアだけのものではなくなってきているように感じます。

ファイルを読み、内容を整理し、表を加工し、レポートを作り、必要に応じて何度かやり直して成果物を作る。こうした「作業相手」としてのAI、いわゆる Cowork 的な使い方が広がりつつあります。

この文脈では、利用者はそれを「AI」と呼ぶこともあれば、「AIエージェント」と呼ぶこともあります。さらに、Claude Code や Codex のような具体的な製品名が、そのまま「賢く作業してくれるもの」の代表名のように使われることもあります。

しかし、実際に仕組みを見ていくと、AI、LLM、AIエージェント、ハーネスは少し分けて考えた方が理解しやすいです。

今回の記事では、AIエージェントを支える「ハーネス」という概念を整理しつつ、いくつかのハーネスを使って、事務作業系・表計算系・コーディング系のタスクを3問だけ試してみた結果を紹介します。

先に結論を言うと、今回の実験は3問だけの予備実験なので、ハーネスやモデルの優劣を決めるものではありません。統計的な有意性もありません。また、評価用の集計ロジックにも、まだデバッグしきれていない部分があります。

それでも、少なくとも今回の範囲では、次のような示唆が得られました。

  • 現代的なハーネスは、コーディングだけでなく事務作業にも使えそう
  • AIエージェントを「LLMにツールを渡してループを回すもの」と捉えるだけでは、現代的なハーネスの振る舞いを説明しにくくなってきた
  • 賢く作業できるようになった一方で、裏側ではかなり大量のトークンを消費している
  • Cowork的な利用を考えるなら、「できるか」だけでなく「いくらで、どの作業なら割に合うか」も重要になる

AI、AIエージェント、ハーネスを分けて考える

まず、この記事での用語を整理します。

用語 この記事でのざっくりした意味
AI 機械学習、LLM、画像認識、推薦システムなども含む広い概念
LLM / モデル 文章を理解・生成する中核部分。GPT、Claude、Gemini など
AIエージェント 目標に向かって、考える、道具を使う、結果を見る、やり直す、というループでタスクを進める仕組み
ハーネス AIエージェントを実際に動かすための実行基盤。ツール、ファイル操作、コマンド実行、ループ制御、ログ、成果物管理などを含む

Cowork文脈では、これらの言葉がかなり混ざって使われがちです。

たとえば、ファイルを渡して「このExcelを整理して」「この資料を要約して」「このCSVからグラフを作って」と依頼できるものがあったとします。利用者から見ると、それは単に「AIが作業してくれた」と見えます。ある人はそれを「AI」と呼び、ある人は「エージェント」と呼び、また別の人は「Claude Codeみたいなもの」と呼ぶかもしれません。

しかし技術的には、そこにはいくつかの層があります。

モデルは、文章を読み、指示を理解し、次に何をすべきかを考える頭脳に近い部分です。AIエージェントは、そのモデルがツールや環境を使いながらタスクを進める仕組みです。そしてハーネスは、そのエージェントを実際に動かすための作業環境です。

人間にたとえるなら、モデルは頭脳、ハーネスは作業机、道具、手順、作業ログ、ファイル置き場を含む環境のようなものです。

ここで重要なのは、最近のAIエージェントの能力はモデルだけで決まっているわけではない、という点です。

もちろんモデル性能は重要です。しかし、ファイルをどう読むか、どのタイミングでコマンドを実行するか、失敗したときにどう戻るか、途中結果をどう保持するか、どこまで探索するか、といった部分はハーネス側の設計にも大きく依存します。

「ツールを渡せばエージェント」から、その先へ

一昔前のAIエージェント理解は、「LLMにツールを渡して、考える・実行する・観察するループを回すもの」という捉え方が中心だったように思います。ReAct はその代表的な考え方の一つで、推論と行動を組み合わせる枠組みとして提案されました。

この考え方は今でも重要です。AIエージェントの基本形を理解するうえでは、ReAct的なループは分かりやすい入口です。

一方で、実務でAIエージェントを使う段階になると、「ツールを渡せばよい」という理解だけでは足りなくなってきました。

最近は、MCPのようにツールやデータソースを接続するための仕組みも整備されつつあります。つまり、ツール接続そのものは以前より標準化されつつあります。

しかし、ツールがつながることと、AIエージェントが賢く作業できることは同じではありません。

実際の作業では、どのファイルを先に読むか、どこまで探索するか、中間結果をどう保持するか、コマンド実行結果をどう解釈するか、失敗したときにやり直すか、別案に切り替えるか、といった判断が大量に発生します。

このあたりが、現代的なハーネスの強さになっているように感じます。

つまり、「LLMにツールを渡してループを回せばエージェントになる」という理解と、Codex CLI、Claude Code、Gemini CLI のような現代的なハーネスの間には、かなり大きな距離があります。

なぜコーディング用ハーネスが事務作業にも使えそうなのか

多くの現代的なハーネスは、もともとコーディング用途から発展してきました。

コードベースを読む、ファイルを編集する、テストを実行する、エラーを見て修正する、差分を作る。これはソフトウェア開発では自然な作業です。

しかし、よく考えると、非エンジニアの事務作業にも似た構造があります。

  • ExcelやCSVを読む
  • 必要なデータを抽出する
  • 表を整形する
  • グラフを作る
  • 複数ファイルを比較する
  • レポートを生成する
  • 出力ファイルを所定の形式で保存する

これは「コードを書く」作業ではありませんが、ファイルを読み、加工し、成果物を作るという意味では、コーディングエージェントの作業環境と近いものがあります。

そこで今回は、いくつかのハーネスを使って、コーディング系だけでなく、事務作業系・表計算系のタスクも試してみました。

実験条件

今回の目的は、モデル単体の優劣を決めることではありません。

モデルとハーネスの組み合わせによって、どの程度タスクを進められるのか。コーディング用に見えるハーネスが、事務作業にも使えるのか。素朴なツール利用型の実装と、現代的なハーネスの間にどれくらい差がありそうか。そして、その裏側でどれくらいトークンやコストを使うのか。

そのあたりを見るために、モデル、ハーネス、評価セットを組み合わせて実験しました。

なお、今回の比較では、Codex CLI、Claude Code、Gemini CLI、OpenCode、mini-SWE-agent、AutoGen、ReActを同じ枠組みで比較し、コーディング評価と事務作業評価を同じ実行基盤で扱えるようにしています。これは実験用の内部構成であり、記事では内部基盤の詳細には踏み込みません。

評価セット

評価セットは以下の3つです。

評価セット 説明
SpreadsheetBench V1 Verified 実世界由来のスプレッドシート操作を評価するベンチマークです。SpreadsheetBench全体は912問で、400問の人手検証済みサブセットが公開されています。本記事では、SpreadsheetBench 2と区別するため、今回使った評価セットを SpreadsheetBench V1 Verified と表記します。
OfficeBench 複数アプリケーションをまたぐ現実的なオフィス自動化ワークフローを評価するベンチマークです。
SWE-bench Verified 実際のGitHub issueをもとに、コードベースを編集して問題を解決するソフトウェアエンジニアリング評価です。Verifiedは人手検証済み500問のsubsetです。

今回は各評価セットからランダムに50問のsubsetを用意し、予備実験としてその先頭3問だけを実行しました。3問はランダムsubset由来ではありますが、サンプル数が非常に少ないため、評価セット全体の難易度分布を代表しているとは限りません。

モデル

今回比較したモデルは、以下の4系統です。

記事内表記 位置づけ
GPT-5.5 OpenAI系モデル
Claude Sonnet 4.6 Claude系モデル
Gemini 3.5 Flash Gemini系モデル
gpt-oss:20b ローカルLLM枠

ハーネス

比較したハーネスは以下です。

記事内分類 実体 説明
純正ハーネス Codex CLI / Claude Code / Gemini CLI 各モデル系列で代表的に使われるベンダー系CLIハーネスです。Codex CLIはOpenAIのローカル実行型coding agent、Claude CodeはAnthropicのagentic coding tool、Gemini CLIはGoogleのオープンソースAI agentです。
AgentCore Amazon Bedrock AgentCore AWSのエージェント実行・運用基盤です。今回はマネージド参考枠として扱います。
OpenCode OpenCode OSS系の現代的なcoding agentです。
mini-SWE-agent mini-SWE-agent SWE-agent系の軽量ハーネスです。
AutoGen AutoGen MicrosoftによるAI agents / applications構築フレームワークです。
ReAct ReAct Reasoning and Actingを組み合わせる古典的なエージェント枠組みです。今回は素朴なツール利用型の比較対象として扱います。

以降の結果表では、行方向をおおむね「純正ハーネス・マネージド参考枠・OSS系現代ハーネス・汎用フレームワーク・素朴なツール利用型」の順に並べています。列方向は、左から GPT-5.5、Claude Sonnet 4.6、Gemini 3.5 Flash、gpt-oss:20b としました。

表中の「純正ハーネス」は、GPT-5.5列では Codex CLI、Claude Sonnet 4.6列では Claude Code、Gemini 3.5 Flash列では Gemini CLI を指します。これは同じハーネスを複数モデルで動かした結果ではなく、各モデル系列で代表的に使われるベンダー系CLIハーネスをまとめて表示したものです。gpt-oss:20b には対応する純正ハーネスを設定していないため、空欄にしています。

実行と評価の単位

今回の予備実験では、各タスクを1回ずつ実行しました。したがって、スコアは pass@k のように複数回試行した成功率ではなく、今回の1回の実行結果に基づく値です。

スコアは、各評価セットの判定方法に従って集計しました。SWE-bench Verified では、生成された修正が対象issueを解決できたかをテストベースで判定します。SpreadsheetBench V1 Verified と OfficeBench では、タスクごとに期待される出力や評価条件に対する達成度を集計しています。

ただし、この記事では評価基盤の内部実装には踏み込まず、各ハーネス・モデルの組み合わせで得られた予備的な傾向を見ることを目的とします。

注意点

今回の実験には、強い制約があります。

注意: 本実験は各評価セット3問だけの予備実験であり、統計的な有意性はありません。また、評価・集計ロジックにはまだデバッグしきれていない部分があり、一部の数値には怪しい箇所が残っている可能性があります。以降の結果はランキングではなく、傾向や論点を見るための予備結果として読んでください。

また、AgentCore は他のCLI / SDK型ハーネスとは実行環境が異なるため、厳密な横並び比較ではなく、参考枠として扱います。

実験結果

スコア

まず、各評価セットのスコアを見ます。

以下の表では、行方向をおおむね「現代的なハーネス → 素朴なツール利用型」の順に並べています。また、列方向は「クラウドモデル → ローカルLLM」の順に並べています。

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 66.7% 0.0% 33.3% -
AgentCore - 16.7% - -
OpenCode 100.0% 16.7% 33.3% 0.0%
mini-SWE-agent 33.3% 16.7% 0.0% 33.3%
AutoGen 33.3% 16.7% 66.7% 33.3%
ReAct 0.0% 0.0% 33.3% 0.0%

SpreadsheetBench V1 Verified:スコア

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 100.0% 100.0% 100.0% -
AgentCore - 100.0% - -
OpenCode 100.0% 100.0% 66.7% 0.0%
mini-SWE-agent 100.0% 100.0% 100.0% 100.0%
AutoGen 100.0% 66.7% 33.3% 66.7%
ReAct 66.7% 66.7% 33.3% 0.0%

OfficeBench:スコア

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 66.7% 33.3% 66.7% -
AgentCore - 33.3% - -
OpenCode 66.7% 33.3% 66.7% 0.0%
mini-SWE-agent 66.7% 33.3% 33.3% 0.0%
AutoGen 66.7% 33.3% 33.3% 0.0%
ReAct 0.0% 0.0% 0.0% 0.0%

SWE-bench Verified:スコア

個別の数値を細かく読むのではなく、表全体の傾向として見ると、いくつかの特徴が見えます。

まず、行方向では、上側に置いた純正ハーネス、AgentCore、OpenCode、mini-SWE-agentのような現代的なハーネスの方が、下側に置いたAutoGenやReActよりスコアが出やすいように見えます。特にReActは、今回の範囲ではSWE-bench Verifiedで苦戦していました。

次に、列方向では、左側に置いたクラウドモデルの方が、右側に置いたローカルLLM枠よりスコアが出やすいように見えます。もちろん、これはOSSモデル一般の限界という意味ではなく、今回使ったモデルサイズ、ハーネス実装、tool callingとの相性、評価タスクとの相性を含んだ結果です。

また、評価セットごとの違いも見えます。今回の3問では、OfficeBenchは比較的スコアが出やすく、SpreadsheetBench V1 Verifiedはばらつきがあり、SWE-bench Verifiedはより難しいタスクに見えました。これは、事務作業系タスクの方が今回の範囲では解きやすく、実コードベースを修正するSWE-bench Verifiedは難度が高い、という感触と合っています。

トークン消費

次に、トークン消費を見ます。

以下の表は、3問平均の消費トークンを k tokens 単位で示しています。たとえば 392.2 は約392,200 tokensです。スコア表と同じく、行方向を「現代的なハーネス → 素朴なツール利用型」、列方向を「クラウドモデル → ローカルLLM」の順に並べています。

なお、トークン消費が 0.0 になっているセルがあります。これは実際に無コストで解けたという意味ではなく、実行失敗、ログ欠損、または集計上の未デバッグ箇所を含んでいる可能性があります。そのため、0.0 のセルは低コストな成功例として解釈しないでください。

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 123.7 174.9 879.2 -
AgentCore - 364.0 - -
OpenCode 170.5 95.3 863.4 16.7
mini-SWE-agent 15.1 139.6 992.1 17.6
AutoGen 17.1 47.2 23.4 11.6
ReAct 4.6 52.1 163.8 12.0

SpreadsheetBench V1 Verified:トークン消費(3問平均、k tokens)

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 252.5 359.8 579.3 -
AgentCore - 834.7 - -
OpenCode 314.3 205.2 362.8 37.8
mini-SWE-agent 29.7 133.7 506.0 31.5
AutoGen 34.1 55.7 24.4 29.0
ReAct 18.2 63.3 60.2 0.0*

OfficeBench:トークン消費(3問平均、k tokens)

ハーネス GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
純正ハーネス 392.2 2175.3 3586.7 -
AgentCore - 1172.8 - -
OpenCode 322.1 878.2 3191.0 53.9
mini-SWE-agent 441.3 1512.0 2015.7 127.8
AutoGen 645.4 904.1 105.4 8.8
ReAct 0.0* 449.7 173.1 68.7

SWE-bench Verified:トークン消費(3問平均、k tokens)

* は実行失敗・ログ欠損・集計上の未デバッグ箇所を含む可能性がある値です。

こちらも個別の値を厳密に比較するのではなく、表全体の傾向として見るのがよさそうです。

大まかには、スコアと同じく、上側に置いた現代的なハーネスほどトークン消費が大きく、下側に置いた素朴なツール利用型ほどトークン消費が小さくなる傾向が見えます。また、列方向でも、左側のクラウドモデルではトークン消費が大きく、右側のローカルLLM枠では小さく見えます。

これはある意味で自然です。現代的なハーネスは、単に一度回答して終わるのではなく、ファイルを読み、探索し、コマンドを実行し、結果を見て、必要に応じてやり直します。そのぶん、スコアが出やすくなる一方で、トークン消費も大きくなります。

特に目立つのは、SWE-bench Verifiedです。SpreadsheetBench V1 VerifiedやOfficeBenchと比べて、SWE-bench Verifiedではトークン消費が一段大きくなっています。実コードベースを読み、問題箇所を探し、修正し、検証する必要があるため、事務作業系タスクよりもトークンが膨らみやすいと考えられます。

コスト

トークン消費は、そのままコストにも効いてきます。

ただし、ここで示すコストは「各モデルで実行した全ハーネス分の合計」です。モデルごとに実行したハーネスの数や種類は完全には揃っていません。特に AgentCore は Claude Sonnet 4.6 の参考枠として追加しているため、Claude Sonnet 4.6 列には他モデルにはない実行分が含まれます。

そのため、以下のコスト表はモデル同士の厳密な価格比較ではありません。今回の予備実験を実際に回したときの費用感、および50問評価へ広げた場合の概算規模を見るためのものです。

3問だけの実績コストは次のようになりました。

評価セット GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
SpreadsheetBench
V1 Verified
¥899.9 ¥1,308.8 ¥2,250.9 ¥0.0
OfficeBench ¥1,648.4 ¥2,365.5 ¥1,153.1 ¥0.0
SWE-bench
Verified
¥4,341.7 ¥9,855.6 ¥6,297.1 ¥0.0
合計 ¥6,890.1 ¥13,529.9 ¥9,701.2 ¥0.0

3問実行時の実績コスト

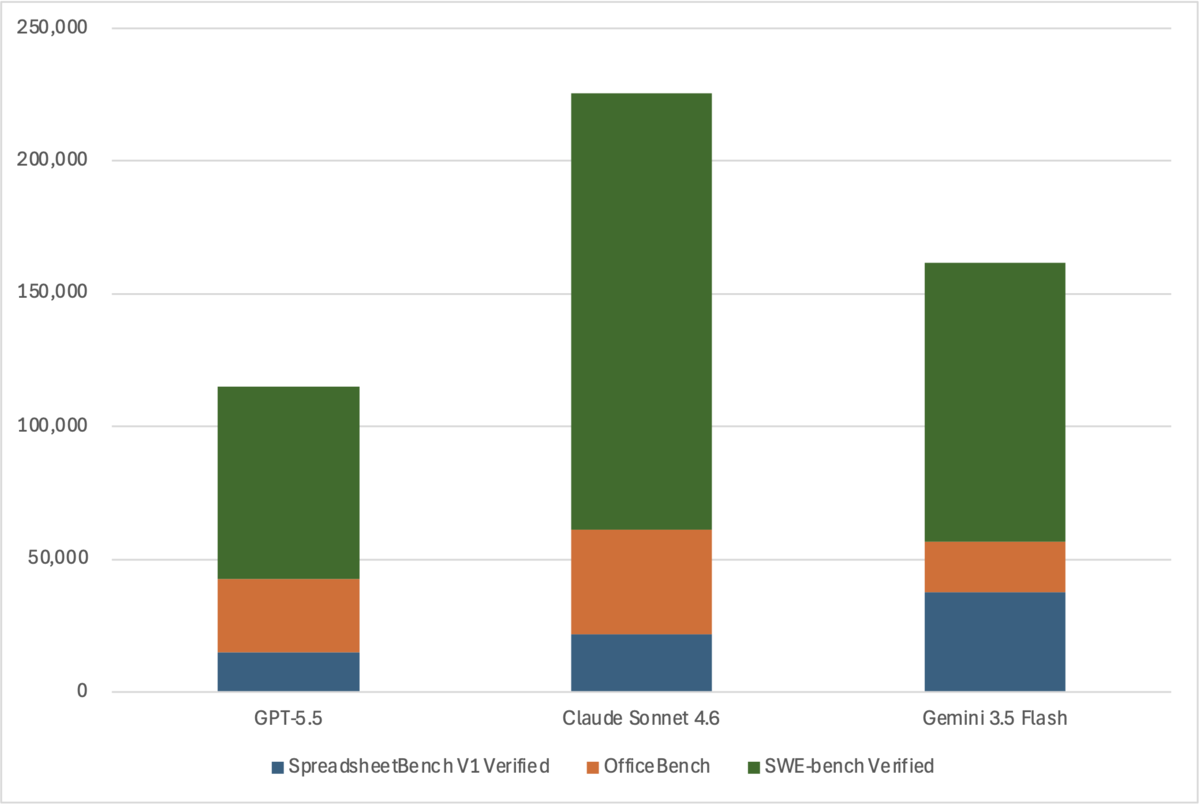
商用モデル3系統の合計だけを見ると、3問ずつの予備実験でも約3万円です。

さらに、これを50問に単純換算すると次のようになります。

評価セット GPT-5.5 Claude
Sonnet 4.6
Gemini
3.5 Flash
gpt-oss:20b
SpreadsheetBench
V1 Verified
¥14,998.9 ¥21,812.9 ¥37,515.5 ¥0.0
OfficeBench ¥27,473.2 ¥39,425.3 ¥19,219.0 ¥0.0
SWE-bench
Verified
¥72,362.3 ¥164,259.5 ¥104,952.2 ¥0.0
合計 ¥114,834.3 ¥225,497.7 ¥161,686.8 ¥0.0

50問実行時の推定コスト

ベンチマーク別・モデル別のコスト

商用モデル3系統を50問ずつ実行すると、単純換算で約50万円規模になります。

もちろん、これは3問の結果を単純に50問へ引き伸ばしただけです。問題の難易度分布、キャッシュ、実行設定、レート、モデル単価、集計方法、実行対象ハーネスの数によって変わります。

それでも、予備実験の段階で「これはフル実験を軽々しく回せない」と分かりました。

考察

スコアとトークン消費はセットで見る必要がある

今回の予備実験で見えた一番大きな傾向は、スコアとトークン消費を別々に見るのではなく、セットで見る必要があるという点です。

表全体を見ると、現代的なハーネスやクラウドモデル側では、スコアが出やすい一方で、トークン消費も大きくなる傾向がありました。逆に、素朴なツール利用型やローカルLLM枠では、トークン消費は小さく見えるものの、スコアも伸びにくい場面がありました。

ただし、これは個別セルごとに「トークンを多く使えば必ずスコアが上がる」という意味ではありません。実際には、少ないトークンで高めのスコアが出ている組み合わせもあれば、多くのトークンを使ってもスコアが伸びていない組み合わせもあります。

したがって、今回の結果は「トークンを燃やせばよい」という話ではなく、現代的なハーネスは大量に読み、探索し、実行し、やり直すことでタスクを進める傾向があり、その結果としてスコアとコストの両方に影響が出る、という読み方がよさそうです。

特にCowork的な事務作業では、ユーザーからは単に「AIがファイルを処理してくれた」と見えます。しかし裏側では、現代的なハーネスがかなり多くのトークンを使って作業している可能性があります。

そのため、実務でAIエージェントを使うときは、「できるか」だけでなく、「その作業をそのコストで任せる価値があるか」を見る必要があります。

事務作業にも一定の適用可能性がありそう

OfficeBenchでは、今回の3問に限ると比較的スコアが出やすい傾向がありました。これだけで「事務作業は十分に解ける」とは言えません。問題がたまたま簡単だった可能性もありますし、評価ロジックに怪しい部分が残っている可能性もあります。

ただし、ファイルを読み、加工し、成果物を作るような作業に対して、コーディング用に発展してきたハーネスが一定の力を発揮しそうだ、という感触はあります。

Cowork的な使い方を考えるうえでは、これは重要です。

非エンジニアの作業をAIが手伝うとき、必要なのは必ずしもコードを書く能力だけではありません。むしろ、ファイルを読み、内容を理解し、必要な操作を行い、最終成果物を作る能力です。

その意味では、コーディングハーネスで発展してきた作業能力は、事務作業にも転用できる可能性があります。

素朴なツール利用型だけでは厳しそう

今回の結果では、下側に置いた素朴なツール利用型ほど、スコアが伸びにくい傾向が見えました。特にSWE-bench Verifiedのように、実際のコードベースを読み、編集し、検証するタスクでは、その傾向が目立ちます。

もちろん、これは今回の実装・プロンプト・評価対象に依存します。ReActそのものが不要という話ではありません。ReActは、AIエージェントの基本構造を理解するうえでは今でも重要です。

ただし、今から実務用のAIエージェントを作るときに、素朴なツール利用型の実装だけで、Codex CLIやClaude Codeのような現代的ハーネスと同じ振る舞いを目指すのは、かなり厳しいのではないかと感じました。

以前は「LLMにツールを渡せばエージェントになる」という理解でも、ある程度は話が通じました。

しかし現在は、探索、編集、実行、検証、リトライ、コンテキスト管理を含むループ全体の作り込みが性能に効いているように見えます。

実務的には、ゼロから手組みで頑張るよりも、既存の現代的ハーネスの能力と制約を理解し、どこで使うべきかを考える方が現実的かもしれません。

ローカルLLMはどう見るか

今回、gpt-oss:20b もローカルLLM枠として試しました。

結果だけを見ると、商用ベンダーモデルと比べて苦戦する場面が多く見えました。特にSWE-bench Verifiedでは、今回の3問ではスコアが伸びませんでした。

ただし、これをもって「OSSモデルは使えない」と言うつもりはありません。

今回の結果には、モデルサイズ、tool callingへの適性、プロンプト、ハーネス側の実装、評価タスクとの相性がすべて含まれています。また、ローカルLLMはAPI課金が0円として扱われていますが、実際には計算資源、運用、チューニング、セットアップのコストがあります。

一方で、データ管理や閉域環境での利用を考えると、ローカルLLMやOSSモデルには別の価値があります。

そのため、今回の結果は「OSSモデル一般の限界」というより、「今回の設定では、現代的な商用モデルの方がタスク遂行には有利に見えた」と解釈するのが妥当だと思います。

まとめ

今回は、AIエージェントを支える「ハーネス」という概念を整理し、いくつかのハーネスを使って、事務作業系・表計算系・コーディング系のタスクを3問だけ試してみました。

繰り返しになりますが、これは3問だけの予備実験です。統計的な有意性はありませんし、評価用の集計ロジックにもデバッグしきれていない部分があります。そのため、ハーネスやモデルの優劣を決めるものではありません。

それでも、いくつかの示唆は得られました。

Codex CLIやClaude Codeのような現代的なハーネスは、もはやコーディングだけの道具ではなく、ファイルを読み、加工し、成果物を作る Cowork 的な作業相手になりつつあります。

一方で、その賢さは無料ではありません。裏側では大量のトークンを使い、SWE-bench Verifiedのような重いタスクでは、3問だけでも無視できないコストになります。

また、AIエージェントを「LLMにツールを渡してループを回すもの」と捉えるだけでは、現代的なハーネスの振る舞いを説明しにくくなってきました。ツール接続は重要ですが、それだけでは差別化になりにくく、探索、編集、実行、検証、リトライを含むループ全体の作り込みが性能に効いているように見えます。

次にやるなら、評価セットや集計ロジックをもう少し安定させたうえで、予算を確保して50問評価まで広げたいです。そのうえで、タスク種別ごとに「どの作業を、どのハーネスに、どれくらいのコストで任せると割に合うのか」を見ていきたいと思います。

ハーネスをサービスとしてどう提供するかは、今回は扱いませんでした。ただ、Cowork的なAI活用を考えるうえでも、ハーネスの性能とコスト構造を理解しておく必要はありそうです。

A100 80GBでOSS VLMのマルチモーダルRAGを比較:A4000 16GBでは起動できなかった理由

はじめに

最近、オープンソースのLLM/VLMの選択肢がかなり増えてきました。

テキスト生成だけでなく、画像を入力できるVLMも増えており、PDFの図表やマニュアル画像をそのままRAGに使えるのではないか、という期待も高まっています。

前回の記事では、PDFに含まれる図表をRAGで扱うために、テキスト抽出、OCR、画像Embeddingなど複数の方法を比較しました。その中で、mode4gのようにページ全体を画像として扱う構成では、検索方式だけでなく、最終的に回答を生成するVLMの性能も重要になることが分かりました。

techblog.heroz.jp

また、別の記事では、A4000 16GB環境で日本語RAG用のOSS LLMを比較しました。テキストRAGでは、A4000 16GBのような比較的安価なGPUでも、gpt-oss 20Bのように実用的に動かせる候補が見えてきました。

(記事リンク)

では、同じようにOSS VLMを使って、マルチモーダルRAGも安価なGPUで動かせるのでしょうか。

結論から言うと、今回の条件ではかなり難しい結果でした。

テキストRAGではA4000 16GBでも現実的なOSS LLMがありましたが、今回試したOSS VLMは、A4000 16GBではどのモデルも起動できませんでした。そのため、今回は社内のA100 80GB環境を使い、vLLMでOSS VLMを起動して比較しています。

今回の記事では、前回と同じデータセットA〜C、同じmode4g構成を使い、回答生成側だけをOSS VLMに差し替えた場合に、どの程度マルチモーダルRAGが成立するのかを見ていきます。

評価条件

前回記事との関係

今回の検証は、前回のPDF図表RAG評価の続編です。

前回は、PDFに含まれる図表をRAGで扱うために、以下のような複数の方式を比較しました。

モード 概要
mode1 テキスト抽出のみ
mode2 OCRテキスト化
mode3 OCR+画像併用
mode4v 画像Embedding(Voyage)
mode4c 画像Embedding(Cohere)
mode4g 画像Embedding(Gemini)

今回は、その中からmode4gを固定して使います。

つまり、検索側は前回の高精度寄り構成に固定し、回答生成側のVLMだけを差し替えて比較します。

データセット

評価データセットは、前回と同じデータセットA〜Cを使用しました。

データセット 問題数 特徴
データセットA 24問 図解のみで構成される難易度の高いケース
データセットB 30問 テキストと図表が混在するケース
データセットC 20問 図とテキストが併記されたマニュアル形式のケース

評価方法

評価は前回と同様に、主に「情報の網羅性」の観点で行いました。

模範回答に含まれる情報がどの程度含まれているか、不要な情報が追加されていないかを1〜5点で評価しています。各質問に対する回答生成と評価は1回ずつ行い、評価には LLM-as-a-Judge を用いました。評価モデルは Claude Sonnet 4.5 です。

LLM-as-a-Judge の評価は回答の長さや表現、評価ごとのばらつきの影響を受ける可能性があるため、小さなスコア差だけで厳密な順位を判断するのではなく、応答時間、VRAM使用量、日本語遵守も合わせて見る方針にしました。

なお、応答時間も集計していますが、今回はデータセットごとの画像サイズの影響も大きいため、本文では主な判断軸を評価スコア、日本語安定性、VRAM使用量に絞っています。

実行環境

前回のテキストRAG評価では、Ollamaを使ってOSS LLMを起動しました。

一方で、今回はVLMを扱うため、vLLMのOpenAI-compatible APIを使っています。vLLMは、1つのプロセスで1つのベースモデルを起動し、OpenAI互換APIとして呼び出す形で利用しました。

A4000 16GBでも試しましたが、今回対象としたOSS VLMはどれも起動できませんでした。そのため、評価はA100 80GB環境で実施しています。

本記事は、同一条件に厳密にモデルサイズや実装条件を揃えたモデル研究というより、A100 80GB環境で実際にvLLMから利用できたOSS VLMを動かした実用寄りの比較として見てください。

なお、ここでのVRAM使用量は、今回実際にvLLMで起動した条件での値です。量子化版の利用、コンテキスト長、画像枚数、画像解像度を変えれば、より小さいGPUで動かせる可能性はあります。本記事では、今回のmode4g評価をそのまま回す実用寄りの条件として比較しています。

評価対象モデル

今回評価したモデルは以下です。

本文中では、読みやすさを優先して Qwen、Kimi、GLM のような表示名で統一します。正式なモデル名は、今回実際にvLLMで起動したHugging Faceのモデル名に合わせています。

表示名 正式モデル名
GPT-5.5 gpt-5.5
Qwen Qwen/Qwen3-VL-8B-Instruct
Kimi moonshotai/Kimi-VL-A3B-Thinking-2506
GLM zai-org/GLM-4.6V-Flash
Gemma google/gemma-4-E4B-it
Ministral mistralai/Ministral-3-14B-Reasoning-2512
Phi microsoft/Phi-4-reasoning-vision-15B

GPT-5.5は、OSS VLMではなく比較用のクラウドモデルとして入れています。今回の主眼は、OSS VLMを実務的なマルチモーダルRAGの回答生成に使えるかどうかです。

結果と考察

評価スコア

まず、データセットA〜Cにおける評価スコアです。

データセット GPT-5.5 Qwen Kimi GLM Gemma Ministral Phi
データセットA 2.71 2.25 1.58 1.96 1.38 2.13 1.67
データセットB 3.07 2.23 1.93 2.67 1.53 2.73 2.00
データセットC 4.00 3.50 2.30 3.25 2.55 3.00 2.15

データセットA〜Cの評価スコア

全体としては、Qwen、GLM、Ministral が上位グループに入りました。

その中で、今回まず試す候補として見やすかったのは Qwen です。データセットA〜Cを通して大きく崩れにくく、日本語回答も安定していました。

GLMやMinistralも上位グループに入っていますが、この記事では「どれを最初に試すか」という観点で、Qwenを中心に見ていきます。

データセットAは図解中心のため、OSS VLMにも難しかった

データセットAは、今回の中でも特に難しい結果になりました。

理由として大きいのは、データセットAが図解中心のタスクであることです。検索された画像の中から、手順、位置関係、部品の向き、矢印の意味などを読み取り、それをもとに回答する必要があります。

データセットBやデータセットCでは上位グループに入るモデルでも、データセットAではスコアが伸びにくくなっています。

前回の記事では、データセットAのような図解中心のタスクでは、Claude Sonnet 4.5 でもスコアが伸びにくい傾向がありました。今回の結果を見ると、OSS VLMでも、少なくとも一部のケースでは Claude Sonnet 4.5 を上回る結果が出ています。

もちろん、これはOSS VLMがクラウドVLM全般を上回るという意味ではありません。前回の比較でも、クラウドVLMの中で図解中心タスクへの向き不向きは分かれていました。今回見えてきたのは、図解中心のRAGではモデルごとの得意不得意が大きく、OSS VLMにも試す価値があるという点です。

非日本語文字の混入はKimiで目立った

日本語RAGでは、回答の主言語が日本語であることに加えて、回答中に不自然な非日本語文字が混じらないことも重要です。

今回は、回答の主言語が日本語であっても、中国語・簡体字・ハングルなどが不自然に混入した割合を集計しました。

モデル データセットA データセットB データセットC
Qwen 0.00% 0.00% 0.00%
Kimi 45.83% 26.67% 40.00%
GLM 25.00% 3.33% 0.00%
Gemma 0.00% 0.00% 0.00%
Ministral 0.00% 3.33% 5.00%
Phi 0.00% 3.33% 0.00%

非日本語文字の混入率

この観点で目立ったのは Kimi でした。複数のデータセットで非日本語文字の混入が多く、日本語RAGの回答としてそのまま使うには注意が必要です。

一方で、Qwen は今回の範囲では非日本語文字の混入が見られませんでした。Qwenを第一候補として見た理由は、評価スコアだけでなく、この日本語安定性も含めたものです。

なお、非日本語文字の集計では、最終回答としてユーザーに返す本文を対象にし、内部のthinking相当の出力は除外しました。

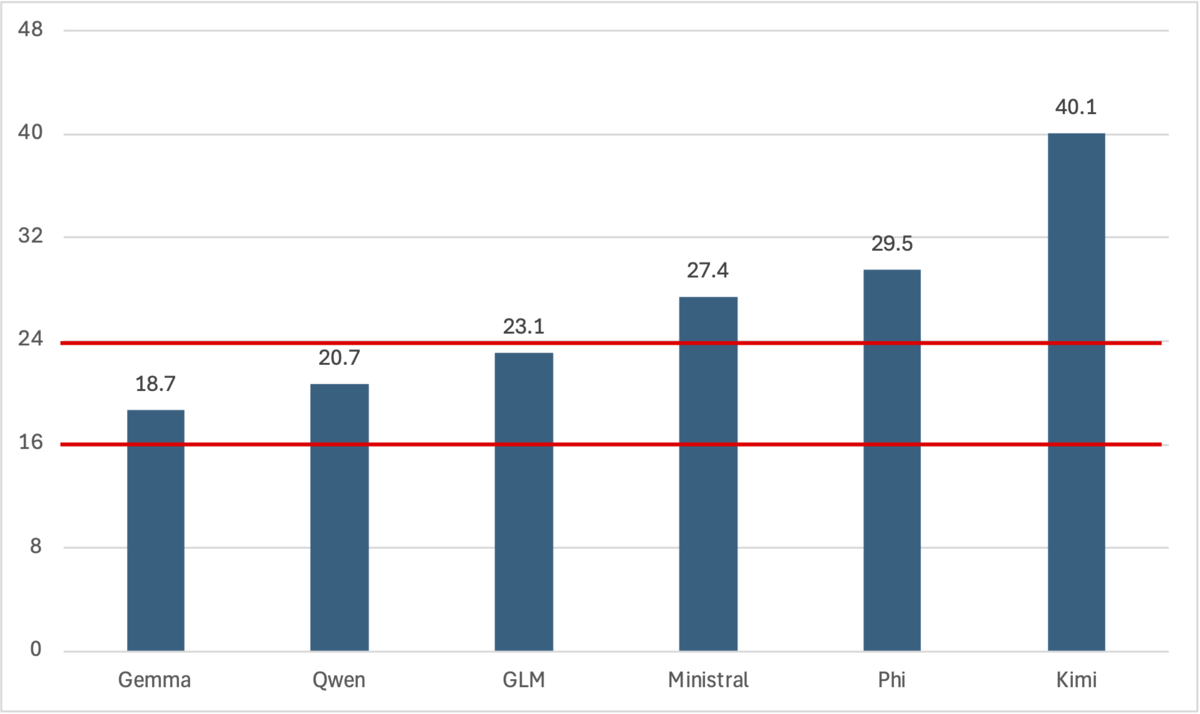
最大の壁はVRAMだった

今回もっとも大きかったのは、GPUメモリの壁です。

VRAM (GB)

テキストRAGでは、A4000 16GBでも評価、応答時間、日本語遵守、VRAM使用量を見ながら、安価なGPUでどこまで成立するかを比較できました。

一方で、VLMでは前提が変わります。画像入力を扱うため、モデル本体だけでなく、画像エンコーダや画像トークン、長いコンテキストを扱うためのメモリも必要になります。

そのため、OSS VLMによるマルチモーダルRAGは、精度だけでなく、利用可能なGPUに収まるかを最初に確認する必要があります。今回の結果では、ここがテキストRAGとの一番大きな違いでした。

まとめ

今回は、A100 80GB環境でOSS VLMを起動し、マルチモーダルRAGの回答生成モデルとして比較しました。

検索方式は前回の記事と同じmode4g固定、データセットも同じデータセットA〜Cを使用しています。前回との違いは、回答生成側をクラウドVLMではなくOSS VLMにした点です。

今回の条件でまず試す候補は Qwen でした。QwenはデータセットA〜Cを通して大きく崩れにくく、非日本語文字の混入も見られませんでした。

一方で、データセットAのような図解中心のタスクは、OSS VLMにとってもまだ難しい結果でした。画像を入力できることと、図解を正しく理解してRAG回答に使えることは別問題です。

また、今回もっとも大きかったのはGPUメモリの壁です。テキストRAGではA4000 16GBでも現実的なOSS LLMがありましたが、VLMでは同じ環境では起動できず、A100 80GBで評価する必要がありました。

OSS VLMによるマルチモーダルRAGは可能性が見えてきています。ただし、現時点ではGPUメモリや運用環境を含めて慎重に設計する必要がある、というのが今回の結論です。

1時間50円級GPUで日本語RAGはどこまで動くのか?A4000 16GBでgpt-oss 20Bを試した

はじめに

最近、オープンソースLLMの選択肢が急速に増えています。gpt-oss、Gemma、Phi、Ministral、Qwen、DeepSeek、LLM-jp など、ローカル環境やGPUクラウド上で利用できるモデルの候補もかなり広がってきました。

一方で、業務利用、特に日本語RAGで使うことを考えると、公開ベンチマークのスコアだけでは判断できません。日本語で安定して回答できるのか、検索文書に忠実に答えられるのか、英語や中国語が不自然に混じらないのか、推論時間は実用的なのか、といった観点が重要になります。

さらに実務では、GPUコストも無視できません。A100のような高性能GPUを使えば大きなモデルを動かしやすくなりますが、すべての用途で高価なGPUを使えるわけではありません。RAG評価、夜間バッチ、大量の社内文書処理のような用途では、「安価なGPUでどこまで成立するか」の方が重要になることもあります。

そこで今回は、GPUSOROBANで利用できる A4000 16GB 環境を使い、日本語RAGタスクで複数のOSS LLMを比較しました。GPUSOROBANは、ローカルPCからクラウド上のNVIDIA GPUインスタンスを利用できるGPUクラウドサービスで、LLMなどの機械学習用途にも利用できます。また、利用料金は1時間50円からで、停止中は課金されないと説明されています。

soroban.highreso.jp

結論から言うと、今回の条件でまず試す候補は gpt-oss 20B でした。

Allganize RAG Dataset では上位グループに入り、J-RAGBench ではクラウドLLM基準に匹敵する結果となりました。また、リトライもほぼ発生せず、日本語遵守も安定していました。

今回の記事では、1時間50円級のA4000 16GBで、日本語RAG用OSS LLMがどこまで実用になるのかを見ていきます。

評価条件

今回は、以下の2種類の日本語RAG評価データセットを使用しました。

データセット 問題数 特徴
Allganize RAG Dataset 207問 エンタープライズサーチ寄り
J-RAGBench 114問 難問寄り

Allganize RAG Dataset は、実務の社内文書検索やFAQに近い性質を持つ評価として見ています。一方で J-RAGBench は、より難しい読解・推論を含むRAG評価として扱いました。

回答生成プロンプトでは、検索文書のみを根拠に日本語で回答するよう明示しました。

与えられた検索文書だけを根拠に、質問に対して日本語で回答してください。

評価は主に「情報の網羅性」の観点で行いました。模範回答に含まれる情報がどの程度含まれているか、不要な情報が追加されていないかを1〜5点で評価しています。各質問に対する回答生成と評価は1回ずつ行い、評価には LLM-as-a-Judge を用いました。評価モデルは Claude Sonnet 4.5 です。

LLM-as-a-Judge の評価は回答の長さや表現の影響を受ける可能性があるため、小さなスコア差だけで厳密な順位を判断するのではなく、応答時間やリトライ回数、日本語遵守も合わせて見る方針にしました。

また、精度だけでなく、次の指標も集計しました。

指標 意味
時間(s) 1回答あたりの平均応答時間
トークン数 1回答あたりの平均出力トークン数
リトライ回数 5分タイムアウトまたは応答失敗による再実行回数
非日本語回答 回答の主言語が日本語以外だった割合
非日本語文字 主言語が日本語でも、中国語・簡体字・ハングルなどが不自然に混入した割合

英語の略語、製品名、技術用語、型番などは、非日本語文字としては扱わない方針にしました。たとえば APIPDFRAG のような表記は許容しています。

評価対象モデル

今回評価したモデルは以下です。

記事中の表示名 実行名 原産エリア
GPT-5.5 none API / reasoning none 米国
GPT-5.5 medium API / reasoning medium 米国
gpt-oss 20B gpt_oss_20b 米国
Gemma 4 E4B gemma4_e4b_it_q4_k_m 米国
Phi-4 Reasoning phi4_reasoning_14b_q4_k_m 米国
Ministral 3 14B ministral_3_14b_instruct_2512_q4_k_m 欧州
Qwen3 8B qwen3_8b 中国
Qwen3 14B qwen3_14b 中国
Qwen3.5 9B qwen3_5_9b 中国
DeepSeek-R1 14B deepseek_r1_14b 中国
LLM-jp 4 8B Instruct llm_jp_4_8b_instruct_gguf_q4_k_m 日本

評価対象モデル

本文中では、読みやすさを優先して gpt-oss 20B、Qwen3.5 9B、LLM-jp 4 8B Instruct のような表示名で統一します。

また、原産エリアは、モデル提供元・開発主体をもとに大まかに整理しています。実行名は、今回実際に利用したOllamaタグに合わせています。本記事は、同一条件に厳密に量子化方式を揃えたモデル研究というより、A4000 16GBで実際に使える形のモデルを動かした実用寄りの比較として見てください。

なお、LLM-jp 4 8B Instruct は、今回利用できるGGUF版を用いて評価しました。公式の配布形態や推奨実行環境そのものを評価したものではないため、LLM-jp 4 の結果は、今回使用したGGUF版での結果として見てください。

結果1:Allganize RAG Dataset

まず、Allganize RAG Dataset の結果です。

モデル 評価 時間(s) トークン数 リトライ
回数
VRAM
(MB)
非日本語
回答
非日本語
文字
GPT-5.5 none 2.81 2.9 2884.4 0 - 0.00% 0.00%
GPT-5.5 medium 2.79 7.3 3180.2 0 - 0.00% 0.00%
gpt-oss 20B 2.74 11.8 3615.3 1 13625 0.00% 0.00%
Gemma 4 E4B 2.73 11.1 3103.2 0 10196 0.00% 0.00%
Phi-4 Reasoning 2.62 69.0 5749.2 10 12990 2.42% 2.90%
Ministral 3 14B 2.75 8.5 3215.3 0 11131 0.00% 0.48%
Qwen3 8B 2.63 12.5 3327.6 2 6307 0.00% 0.00%
Qwen3 14B 2.67 21.2 3331.1 1 10350 0.00% 0.97%
Qwen3.5 9B 2.61 228.3 5697.5 146 8556 0.97% 1.93%
DeepSeek-R1 14B 2.49 13.9 3067.1 0 10360 0.00% 4.83%
LLM-jp 4 8B Instruct 2.28 4.2 2389.0 0 - 0.48% 0.48%

Allganize RAG Dataset の評価結果

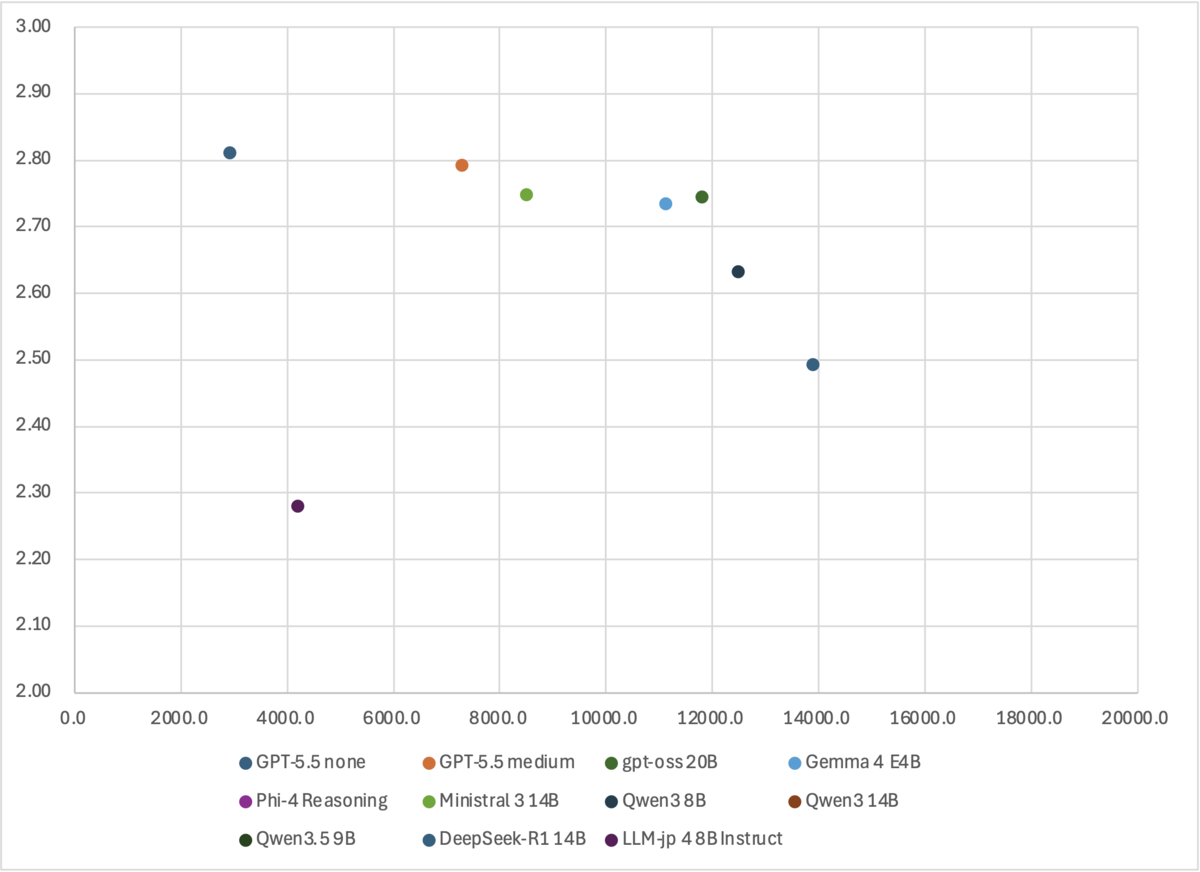
Allganize:評価スコアと応答時間

Allganize RAG Dataset では、Ministral 3 14B、gpt-oss 20B、Gemma 4 E4B が上位に入りました。スコア差は小さく、このデータセットではこの3モデルがほぼ同程度の結果だったと見ています。

この時点では、どれか1つが明確に抜けているというより、A4000 16GBでも複数のOSS LLMが実務寄りRAGで十分戦えることが分かります。

一方で、表を見ると、平均スコア以外の指標には大きな差があります。特に応答時間、リトライ回数、日本語遵守にはモデルごとの特徴が出ているため、これらは後の節で詳しく見ます。

なお、Qwen3.5 9B は応答時間が大きく外れているため、散布図では表示範囲外としています。詳細は表の時間とリトライ回数を参照してください。

結果2:J-RAGBench

次に、J-RAGBench の結果です。

モデル 評価 時間(s) トークン数 リトライ
回数
VRAM
(MB)
非日本語
回答
非日本語
文字
GPT-5.5 none 2.32 2.1 2162.8 0 - 0.00% 0.00%
GPT-5.5 medium 2.61 5.9 2387.4 0 - 0.00% 0.00%
gpt-oss 20B 2.68 6.1 2625.2 0 13625 0.00% 0.00%
Gemma 4 E4B 2.55 9.3 2601.6 0 10196 0.00% 0.00%
Phi-4 Reasoning 2.11 8.9 3063.1 0 12990 0.00% 0.00%
Ministral 3 14B 2.44 3.2 2375.1 0 11131 0.00% 0.00%
Qwen3 8B 2.38 15.1 2998.0 5 6307 0.00% 0.00%
Qwen3 14B 2.46 22.0 2877.3 3 10350 0.00% 0.00%
Qwen3.5 9B 2.18 349.3 4070.7 117 8556 0.00% 0.88%
DeepSeek-R1 14B 2.22 9.7 2430.5 0 10360 0.00% 2.63%
LLM-jp 4 8B Instruct 2.36 1.1 1838.7 0 - 0.00% 0.00%

J-RAGBench の評価結果

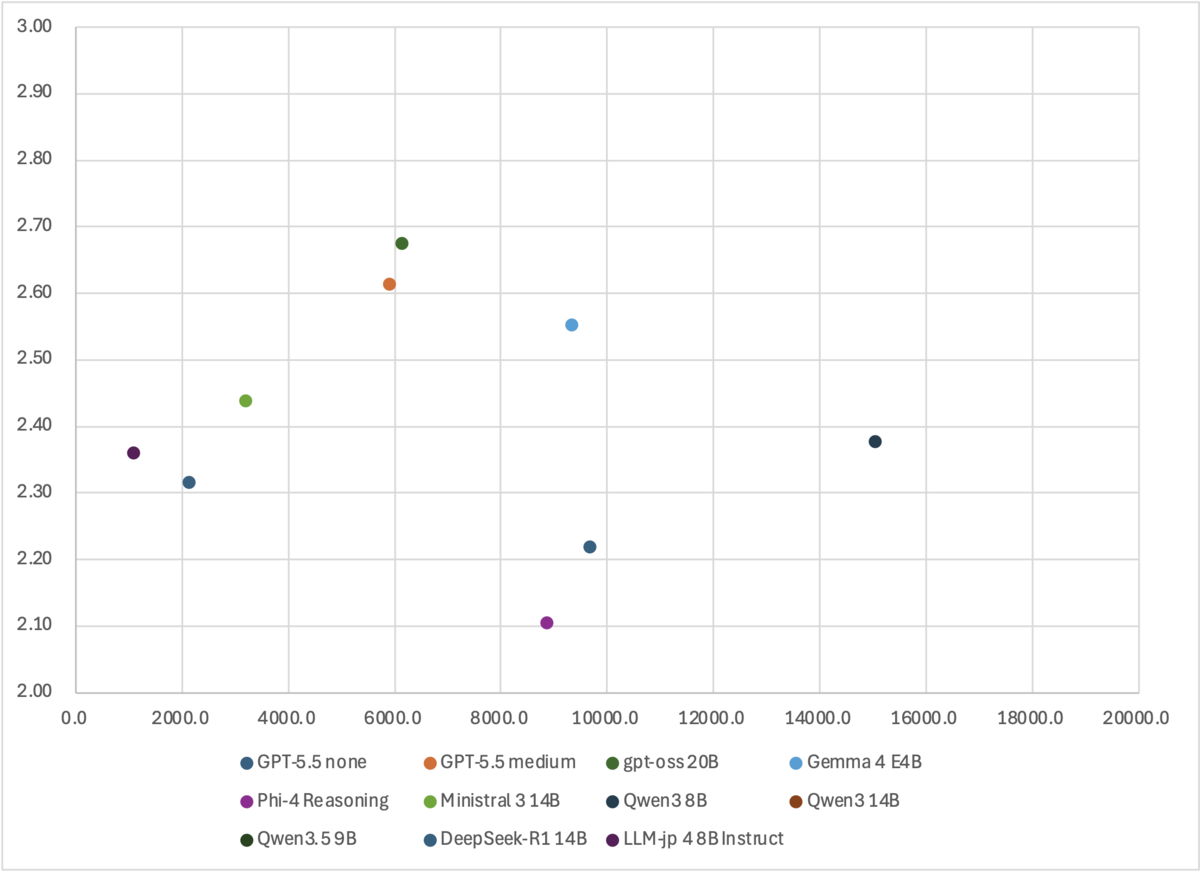
J-RAGBench:評価スコアと応答時間

J-RAGBench では、gpt-oss 20B、GPT-5.5 medium、Gemma 4 E4B が上位に入りました。難問寄りのRAG評価でも、gpt-oss 20B はクラウドLLM基準に匹敵する結果となっています。

ここで重要なのは、gpt-oss 20B が単に高いスコアを出したことだけではありません。A4000 16GBに収まるモデルでありながら、難問寄りのデータセットでもクラウドLLMと同じ上位グループに入った点です。

一方で、J-RAGBenchでもモデルごとの運用上の差は大きく出ました。応答時間やリトライ回数、日本語遵守の違いは、平均スコアだけでは見えにくいため、次の節で整理します。

なぜ gpt-oss 20B を推すのか

ここまでの結果を踏まえると、今回の条件でまず試す候補は gpt-oss 20B だと感じました。

観点 Allganize J-RAGBench
評価 2.74 2.68
時間(s) 11.8 6.1
リトライ回数 1 0
非日本語回答 0.00% 0.00%
非日本語文字 0.00% 0.00%
VRAM(MB) 13625 13625

Allganize RAG Dataset では上位グループに入り、J-RAGBench でもクラウドLLM基準に匹敵する結果でした。さらに、リトライがほぼ発生せず、日本語遵守も安定していました。

また、A4000 16GBでVRAM使用量が約13.6GBに収まった点も重要です。1時間50円級のGPUで動かせる範囲に収まりつつ、日本語RAGで十分な品質を出せるなら、検証やバッチ処理用途ではかなり現実的な選択肢になります。

実務的には、最高スコアだけでなく、安定して返ってくること、日本語を守ること、GPUメモリに収まることが大事です。この観点で見ると、今回の範囲では gpt-oss 20B が最も「まず試しやすい」候補でした。

日本語RAGでは、日本語として安定して返ることも重要

日本語RAGでは、回答の内容だけでなく、日本語として安定して返ってくることも重要です。特に業務システムや顧客向け用途では、回答中に突然英語や中国語が混じると、内容以前に信頼感を損ないます。

今回、gpt-oss 20B は Allganize / J-RAGBench の両方で、非日本語回答・非日本語文字ともに 0.00% でした。一方で、DeepSeek-R1 14B は Allganizeで非日本語文字 4.83%、J-RAGBenchで 2.63% となりました。

平均スコアだけを見ると見落としやすいですが、日本語RAGの実運用では、この差はかなり重要です。

reasoningが過剰に走るモデルはRAGで扱いにくい

RAGでは、検索文書に含まれる情報をもとに、必要十分な回答を安定して返すことが重要です。一方で、モデルによっては推論機能が過剰に働き、回答生成が長引いたり、出力が膨らんだり、タイムアウトに到達したりするケースがあります。

今回その傾向が最も強く出たのが Qwen3.5 9B でした。今回のA4000環境では、応答が返らない、または5分タイムアウトに到達するケースが多く発生しました。Allganizeではリトライ146回、J-RAGBenchではリトライ117回となっており、通常のRAG用途にそのまま使うにはかなり厳しい挙動でした。

Phi-4 Reasoning も、Allganizeでは平均応答時間と出力トークン数が大きくなりました。こちらはQwen3.5 9Bほど極端ではありませんが、推論が重く出ると、質問によって応答時間が大きく伸びる可能性があります。

もちろん、推論機能そのものが悪いわけではありません。複雑な問題では有効に働く場面もあります。ただ、日本語RAGのように「検索文書を根拠に、必要な情報を簡潔に返す」用途では、推論が過剰に走ると、精度よりも先に応答時間や安定性が問題になります。

今回の条件では、Qwen3.5 9B のように推論が過剰に走るモデルは、スコア以前に応答時間とリトライ回数がボトルネックになりました。

なお、gpt-oss 20B も reasoning に対応したモデルですが、今回利用したOllamaタグでは、Qwen3.5 9B のような応答なしやタイムアウト多発は見られませんでした。今回の結果を見る限り、reasoning に対応しているかどうかよりも、実際の実行設定で推論が過剰に膨らまず、RAG回答として安定して返ってくるかが重要だと感じました。

まとめ

今回は、1時間50円級のA4000 16GB環境で、日本語RAG用OSS LLMを比較しました。

今回の条件でまず試す候補は gpt-oss 20B でした。Allganize RAG Dataset では上位グループに入り、J-RAGBench ではクラウドLLM基準に匹敵する結果となりました。リトライがほぼ発生せず、日本語遵守も安定しており、A4000 16GBでVRAM使用量が約13.6GBに収まった点も実用上大きいです。

一方で、平均スコアだけでは実用性は判断できません。Qwen3.5 9B のように、reasoningが過剰に走って応答時間やリトライ回数が大きくなるモデルもあります。また、DeepSeek-R1 14B のように、日本語回答中の非日本語文字混入が課題になるケースもありました。

今回の結果からは、安価なA4000 16GB環境でも、日本語RAG用OSS LLMは十分に検討できると感じました。ただし、選ぶときは平均スコアだけでなく、応答時間、リトライ回数、日本語遵守まで含めて見る必要があります。

Vertex AIのEmbedding TuningはRAGを改善するのか?検索精度・汎用性・運用コストで検証してみた

はじめに

RAG(Retrieval-Augmented Generation)は、LLMに外部知識を与えるための現実的な手法として広く使われるようになりました。弊社でも、社内外の文書検索、業務知識の活用、専門領域の問い合わせ対応などで検証を進めています。

一方で、最近はRAGの汎用的な精度向上がある程度打ち止めになってきた感覚があります。チャンク分割、クエリ書き換え、ハイブリッド検索、rerankingなどで着実な改善は可能ですが、既に一定水準に達したパイプラインをさらに大きく伸ばすのは簡単ではありません。

特に課題になるのが、顧客固有・業界固有の用語です。

  • 社内略語・製品コードネーム
  • 業界特有の言い回し
  • 一般語としては近くないが業務上は強く関連する語
  • 似ているが区別が必要な概念

ここで重要なのは、LLM本体が専門用語を知っていることと、Embeddingが適切に検索できることは別問題だという点です。

最近のフロンティアモデルは、KubernetesのようなIT系の用語や、ある程度一般化された業界知識をかなり知っています。そのため、最終的な回答だけを見ると、LLMの内蔵知識でそれなりに答えられることがあります。

しかしRAGでは、まずRetrieval段階で正しい文書を引ける必要があります。LLM本体が知っている用語であっても、Embeddingモデルがその用語の言い換え、略称、近い概念との差分をうまく表現できなければ、正しいチャンクに到達できません。

つまり、問題は「LLMが答えを知っているか」だけではなく、Retrieval段階で正しい文書に到達できるかにもあります。

この「検索で取りこぼす」問題を解決するために、Embedding自体をドメインに合わせてfine-tuningできないか、というのが今回の出発点です。

本記事では、Vertex AIの Tune text embeddings を使い、Embedding tuningがRAGの検索性能と最終回答品質に与える影響と、そのコスト面での現実を検証します。

結論から言うと、今回の検証では Embedding tuningは対象ドメインに対してbase比で改善しました。また、別データセットでのデグレも小さく、汎用性能が大きく壊れることもありませんでした。

一方で、最新のGemini Embeddings 2がチューニングなしで同等以上の性能を示すケースもありました。さらに、チューニング済みモデルの推論にはVertex AI Endpointでの推論リソース管理が必要であり、通常のEmbedding APIのようにそのままserverlessに呼び出せるものではありませんでした。

今回のまとめは次の通りです。

Embedding tuningは効く。ただし、軽くはない。
さらに、最新のフロンティアEmbeddingモデルがチューニングなしで同等以上になるケースもある。
そのため、まずは通常のRAG改善や最新Embeddingモデルを試し、それでも顧客固有語や業界用語の検索に課題が残る場合に検討するのが現実的です。

背景

基盤モデルのfine-tuningで感じていた難しさ

fine-tuning自体には以前から期待がありました。

ドメイン知識を追加する、顧客ごとの業務に合わせる、専門領域に強くする、といった話をすると、自然とfine-tuningという選択肢が出てきます。ビジネス面でも「顧客専用モデル」「業界特化モデル」という響きは分かりやすく、期待されやすい技術です。

ただ、基盤モデル、つまりLLM本体をfine-tuningする場合には、実務上いくつかの壁があります。

まず、fine-tuningはベースモデルの能力を大きく超える魔法ではありません。ベースモデルの知識量や推論力が十分でない場合、少量のドメインデータを追加しても、最新のフロンティアモデルに追いつくのは簡単ではありません。

次に、ドメイン知識を追加するだけでは、実用的なチャットモデルにはなりません。ユーザーの指示に従う、指定された形式で回答する、余計なことを言わない、といったinstruction followingの能力も必要になります。ドメイン知識のfine-tuningとinstruction tuningをどう両立させるかは、思った以上に大きな問題でした。

最後に、運用コストがあります。fine-tuningした基盤モデルを実運用するには、何らかのGPUリソースが必要になります。モデルサイズが大きくなるほど、学習だけでなく推論時のコストも重くなります。精度が多少上がっても、運用コストまで含めると見合わない、という判断になりがちです。

まとめると、基盤モデルのfine-tuningには次のような難しさがあります。

  • ベースモデルの能力に強く依存する
  • ドメイン知識だけでなくinstruction followingも考える必要がある
  • 学習後の推論コストが重い

このため、基盤モデルのfine-tuningは効果があったとしても、実用化まで考えるとかなり重い取り組みになります。

なぜEmbeddingのfine-tuningに注目したか

そこで発想を変えて、Embeddingだけをfine-tuningすることを考えました。

Embeddingであれば、基盤モデルのfine-tuningで問題になりやすい点をいくらか回避できるかもしれません。

Embeddingモデルは回答文を生成しないため、生成品質やinstruction followingには直接影響しません。学習対象も「このクエリとこの文書は近い」という関係であり、基盤モデル全体に新しい知識や振る舞いを覚えさせるよりも、問題を切り分けやすくなります。

また、RAGの性能を分解すると、RetrievalとGenerationに分けられます。Embeddingのfine-tuningは、このうちRetrievalだけをピンポイントで改善する手法です。効果測定もしやすく、RAG全体の改善施策として扱いやすいと考えました。

さらに、Vertex AIにはEmbeddingをチューニングできるmanagedサービスが用意されています。もし学習から推論までmanagedかつserverlessに近い形で使えるなら、基盤モデルfine-tuningで問題になった運用コストの壁を越えられるかもしれません。

この期待から、Vertex AIの Tune text embeddings を試すことにしました。

Vertex AI「Tune text embeddings」

Vertex AIには、テキストEmbeddingを教師ありでチューニングする Tune text embeddings という機能があります。

公式ドキュメントはこちらです。

https://cloud.google.com/vertex-ai/generative-ai/docs/models/tune-embeddings

今回使用したベースモデルは text-multilingual-embedding-002 です。日本語クエリで評価したかったため、多言語モデルを選びました。

また、比較対象としてOpenAIのtext-embedding-3-largeと、Gemini Embeddings 2 (gemini-embedding-2)も使用しました。

Google Cloudのドキュメントでは、公開ベンチマークにおいて、Embedding tuningにより最大41%、平均12%の品質改善があったと説明されています。

この数字だけを見ると、RAGの検索精度改善手法としてかなり魅力的です。

学習コスト

Tune text embeddingsの学習はVertex AI Pipelines上で実行され、GPUインスタンスの利用時間に応じた従量課金になります。

今回の検証では、学習時間はおよそ2時間で、コストは数ドル程度でした。少なくとも小規模な検証であれば、学習コスト自体はかなり軽い印象です。

この時点では、学習がこれだけ軽いなら、推論も通常のEmbedding APIのようにserverlessで使えて、トークン課金ではないかと期待していました。

この期待は、後半で少し裏切られます。

Embedding fine-tuningの学習データ

tripletの考え方

Embeddingのfine-tuningでは、クエリと文書の関係を学習します。

概念的にはtripletで考えると分かりやすいです。

  • anchor: 検索クエリ
  • positive: 正解文書
  • negative: 不正解文書

例えば、Kubernetesのドキュメントで考えると、次のようなイメージです。

  • anchor: 「コンテナが何度も落ちて再起動する原因を調べたい」
  • positive: anchorに関係するCrashLoopBackOffに関する説明チャンク
  • negative: anchorに関係しないDeploymentのreplica数に関する説明チャンク

このとき、Embedding空間上ではanchorとpositiveを近づけ、anchorとnegativeを遠ざけたいわけです。

ただし、Vertex AIのTune text embeddingsでは、明示的なtriplet形式そのものではなく、以下の3つのファイルを用意します。

corpus.jsonl

検索対象となる文書群です。

1行1JSONのJSONL形式で、各行に文書IDと本文を入れます。

{"_id": "doc_001", "text": "..."}

今回の実験では、対象文書をチャンク分割し、各チャンクを1つのcorpus itemとして扱いました。

queries.jsonl

検索クエリの一覧です。

{"_id": "query_001", "text": "..."}

ここが今回のデータ作成で一番重要な部分です。

単にチャンク本文をそのまま質問にすると、キーワード一致で解ける簡単な評価セットになってしまいます。それではEmbedding tuningの差が出にくくなります。

そこで今回は、各チャンクの内容からLLMでクエリを生成する際に、次のような特徴を持たせました。

  • 本文中の用語を別の自然な表現に言い換える
  • 具体的な用語を少し抽象化する
  • 似た概念と混同しやすい聞き方にする
  • 単語一致だけではなく、文脈理解が必要になるようにする

つまり、単なるQAデータではなく、Retrievalが少し難しくなる評価データを意図的に作っています。

例えば、本文にある専門用語をそのまま質問に含めるのではなく、実際のユーザーが曖昧に問い合わせそうな表現に寄せます。これにより、単純なlexical overlapではなく、意味的に正しいチャンクを引けるかを評価しやすくなります。

train_labels.tsv

クエリと文書の対応関係を表すラベルです。

query_id corpus_id score

scoreは、そのクエリと文書の関連度を表します。

今回は、各チャンクから生成したクエリに対して、そのチャンク自身を正例として扱いました。つまり、「このチャンクの内容から作ったクエリなら、このチャンクに戻ってきてほしい」という教師データです。

本格的には、似ているが正解ではない文書、いわゆるhard negativeも丁寧に設計した方がよいです。ただ、今回はまず実験基盤の構築と、Embedding tuningの効果確認を優先しました。

実験

実験設定

今回は、2つのデータセットで検証しました。

1つ目は、Kubernetes公式ドキュメントです。

Kubernetesを選んだ理由は、公式ドキュメントが整備されていて取得しやすく、用語や概念も多いためです。一方で、KubernetesはLLMやEmbeddingモデルにとって比較的得意な領域でもあります。そのため、今回の実験は「未知ドメインに対する最終検証」ではなく、「Embedding tuningの効果が出るかを確認する」位置づけです。

2つ目は、某損害保険会社の約款です。

こちらは、Kubernetesよりも業務ドメイン寄りのデータとして用意しました。約款は表現や条項の構造に独特さがあり、一般的なWeb知識やITドキュメントとは異なる性質があります。顧客固有・業界固有の検索課題に近い対象として、Embedding tuningの効果を確認するために使用しました。

なお、某損害保険会社の約款は非公開データを含むため、本文ではデータの詳細は記載せず、概要と評価結果のみを扱います。

対象 評価データ
Kubernetes公式ドキュメント 50件
某損害保険会社の約款 78件

比較したEmbeddingモデルは次の通りです。

表記 モデル
Vertex base text-multilingual-embedding-002
Vertex tuned text-multilingual-embedding-002 を対象データでチューニングしたもの
OpenAI text-embedding-3-large
Gemini Embeddings 2 gemini-embedding-2

RAGとしての最終回答品質も確認しました。

項目 内容
回答生成 gpt-5.4
評価方法 LLM as a judge
評価モデル Claude Sonnet 4.5
評価スケール 1〜5点

なお、RAG最終品質の評価にはLLM-as-a-Judgeを用いています。LLMによる評価にはスコアのばらつきや評価モデルのバイアスが含まれる可能性があるため、ここでのスコアは絶対的な性能値ではなく、同一条件内での相対比較として扱っています。

Retrieval評価の指標

Retrieval評価では、主にMRR(Mean Reciprocal Rank)を見ました。

MRRは、正解チャンクの順位の逆数を平均した指標です。正解が1位なら1.0、2位なら0.5、5位なら0.2になります。RAGでは、正解チャンクが単に検索候補に含まれるだけでなく、できるだけ上位に来ることが重要なので、MRRは実用上かなり重要な指標です。

結果

Retrieval性能

まず、Retrieval性能です。ここではMRRを比較します。

モデル Kubernetes
MRR
損害保険の約款
MRR
Vertex base 0.19 0.26
Vertex tuned 0.37 0.31
OpenAI 0.26 0.23
Gemini Embeddings 2 0.42 0.34

Retrieval性能

Kubernetesでは、Vertex tunedのMRRが0.19から0.37へ改善しました。ほぼ2倍です。

某損害保険会社の約款でも、Vertex tunedは0.26から0.31へ改善しました。改善幅はKubernetesほど大きくありませんが、base比では改善しています。

この結果から、少なくとも今回の条件では、Embedding tuningによって対象ドメインのRetrieval性能は改善することが分かりました。

一方で、Gemini Embeddings 2にも注目する必要があります。Kubernetesでは0.42、某損害保険会社の約款では0.34で、どちらもVertex tunedを上回りました。

つまり、Embedding tuningはbase比では効くものの、最新のフロンティアEmbeddingモデルがチューニングなしで同等以上の性能を示すケースがあります。

RAGとしての最終品質

次に、検索結果を使って実際にRAGで回答させた場合のスコアを比較します。

モデル Kubernetes
score
損害保険の約款
score
no RAG 2.24 2.15
Vertex base 2.42 2.78
Vertex tuned 3.04 3.06
OpenAI 2.68 2.83
Gemini Embeddings 2 3.02 3.21

RAGの品質

Kubernetesでは、Vertex tunedはVertex baseに対して2.42から3.04へ改善しました。RAGの最終回答品質でも、Embedding tuningの効果が確認できました。

某損害保険会社の約款でも、Vertex tunedは2.78から3.06へ改善しました。こちらも、Retrieval性能と同じくbase比で改善しています。

一方で、Gemini Embeddings 2はKubernetesでは3.02とVertex tunedにほぼ同等、某損害保険会社の約款では3.21と最も高いスコアになりました。

ここで見えてくるのは、次のような傾向です。

  • Embedding tuningは対象ドメインでbase比の改善を出す
  • その改善はRAG最終品質にも一定反映される
  • ただし、最新のGemini Embeddings 2がチューニングなしで同等以上になる場合がある

Retrieval評価ではMRRが大きく改善していても、RAGの最終スコアの改善幅はそれより小さくなることがあります。これは自然な結果だと思います。

RAGの最終回答は、検索だけで決まるわけではありません。

  • LLMが元々持っている知識
  • 検索結果の読み取り能力
  • プロンプトの設計
  • 評価データの難易度
  • top-kに入っていれば何位でも回答できるケース

などが絡みます。

特にKubernetesのような一般的なIT知識では、フロンティアモデルが内蔵知識だけである程度答えられるケースもあります。そのため、検索順位が大きく改善しても、最終回答の改善幅は圧縮されます。

汎用データでのデグレ確認

fine-tuningでは、対象ドメインに最適化される一方で、汎用性能が壊れる可能性があります。

そこで、チューニングしたEmbeddingモデルが、別のRAGデータセットで劣化しないかを確認しました。

デグレ確認には、Allganize RAG Evaluation Dataset JAを使用しました。

https://huggingface.co/datasets/allganize/RAG-Evaluation-Dataset-JA

結果は次の通りです。

モデル Kubernetes
tuned
損害保険の約款
tuned
no RAG 1.92 1.88
Vertex base 2.98 2.92
Vertex tuned 2.90 2.84
OpenAI 2.86 2.99
Gemini Embeddings 2 2.95 2.93

デグレ確認

Kubernetesでチューニングしたモデルは、Vertex baseに対して-2.4%でした。某損害保険会社の約款でチューニングしたモデルは、Vertex baseに対して-2.6%でした。

どちらも少し低下していますが、大きなデグレとは言いにくい結果です。少なくとも今回の範囲では、Embedding tuningしても、汎用的な日本語RAG評価セットで大きく性能が壊れることはありませんでした。

これは重要な結果です。

Embedding tuningが対象ドメインで効いたとしても、他ドメインで大きく壊れるなら、実用上はかなり扱いづらくなります。しかし今回の結果では、対象ドメインで改善しつつ、汎用データでは大きな劣化は見られませんでした。

考察

ここまでの結果は良好でした

ここまでの結果だけを見ると、Embedding tuningはかなり有望に見えます。

  • KubernetesドメインではRetrieval性能が大きく改善
  • 某損害保険会社の約款でもRetrieval性能が改善
  • RAGの最終回答品質も改善
  • 汎用データでの大きなデグレは見られない

基盤モデルのfine-tuningと比べると、Embedding tuningはかなり扱いやすい印象でした。

基盤モデルのfine-tuningでは、モデルの回答品質、instruction following、ハルシネーション、運用コストなど、考えることが多くなります。一方でEmbedding tuningは、検索対象との距離関係を改善する話なので、評価対象をRetrievalに切り分けやすいです。

RAGの改善手法としては、かなり素直です。

また、今回の追加検証で分かった重要な点として、某損害保険会社の約款のような業務ドメイン寄りのデータでも、base比では改善が見られました。これは、Embedding tuningがKubernetesのようなITドキュメントだけに効くわけではない、という意味で前向きな結果です。

ただし、最新のフロンティアEmbeddingモデルは強い

一方で、今回の結果ではGemini Embeddings 2が非常に強い結果を示しました。

Kubernetesでは、Gemini Embeddings 2がRetrieval性能で最も高く、RAG最終品質でもVertex tunedとほぼ同等でした。

某損害保険会社の約款でも、Gemini Embeddings 2がRetrieval性能とRAG最終品質の両方で最も高いスコアになりました。

この結果から、Embedding tuningを考えるときには、単に「baseモデルから改善するか」だけでは不十分だと分かります。

実務上は、次の比較が必要です。

  • Vertex baseと比べて改善するか
  • 最新のEmbeddingモデルと比べて優位があるか
  • 改善幅が運用コストに見合うか

今回の検証では、Vertex tunedはbase比では改善しました。しかし、Gemini Embeddings 2と比較すると、同等または下回る結果でした。

つまり、チューニング済みモデルを作って運用する前に、まず最新のフロンティアEmbeddingモデルを試す価値はかなり大きいと感じました。

さらに、推論時にGPU endpointが必要だった

実際に進めてみると、もう1つ大きな問題がありました。

Tune text embeddingsは、学習自体はVertex AIのmanagedな仕組みで実行できます。しかし、チューニング済みEmbeddingモデルは、通常のEmbedding APIのようにそのまま呼び出せるわけではありません。

チューニング済みモデルを使うには、Vertex AI Endpointにデプロイし、推論に使うmachine typeやacceleratorなどのリソースを管理する必要があります。

当初は、managed serviceという言葉から、学習後の推論も通常のEmbedding APIのようにserverlessに近い形で使えることを期待していました。

しかし実際には、チューニング済みEmbeddingモデルを運用するには、推論リソースをどこかで確保する必要があります。

これはかなり大きな違いです。

RAGのEmbeddingは、通常の検索クエリごとに呼ばれます。社内向けRAGや顧客向けRAGで常時GPU endpointを立てるとなると、利用頻度が十分に高くない限り、コストが見合わない可能性があります。

Embedding tuningによるRAG最終品質の改善に対して、GPUを含む推論リソースの運用コストを払うか、という判断になります。

ここはかなり悩ましいです。

Embedding tuningは「効くが軽くはない」

今回の実験から分かったことを整理します。

まず、Embedding tuningそのものには効果があります。

Kubernetesでも某損害保険会社の約款でも、Vertex baseと比較してRetrieval性能は改善しました。特にKubernetesではMRRがほぼ2倍になりました。正解チャンクがより上位に来るようになるため、RAGの検索品質改善としては素直に効いています。

また、RAGの最終回答品質も改善しました。

ただし、Retrievalの改善幅に比べると、最終回答の改善幅は小さくなります。これは、フロンティアモデルが元々ある程度の知識を持っていることや、検索結果の順位差を回答生成側がある程度吸収できることが理由だと思います。

次に、汎用性能のデグレは大きくありませんでした。

Kubernetesでチューニングしたモデルも、某損害保険会社の約款でチューニングしたモデルも、Allganize RAG Datasetで評価した範囲では、Vertex baseに対して-2.5%前後の低下に収まりました。この点は良い結果です。

一方で、最新のGemini Embeddings 2は非常に強い結果でした。今回の範囲では、Vertex tunedと同等またはそれ以上の性能を、チューニングなしで示しました。

さらに、最大の課題は運用コストです。

学習がmanagedで安価にできても、推論が通常のEmbedding APIのように使えないなら、実運用のハードルはかなり上がります。特にRAGの検索用途では、Embedding生成は高頻度に呼ばれる可能性があるため、GPU endpointのコストは無視できません。

つまり、今回の結論は次のようになります。

Embedding tuningはRetrievalを改善する。
RAGの最終回答品質にも一定の効果がある。
汎用性能も大きくは壊れない。
ただし、最新のフロンティアEmbeddingモデルがチューニングなしで同等以上になるケースがある。
さらに、推論時のGPU運用コストを考えると、適用できるケースは限られる。

おわりに

本記事では、Vertex AIのTune text embeddingsを使い、Embedding tuningがRAGを改善するのかを検証しました。

結果として、Kubernetesドキュメントと某損害保険会社の約款を対象にした評価では、Retrieval性能が改善し、RAGの最終回答品質も向上しました。また、Allganize RAG Datasetを使ったデグレ確認では、大きな汎用性能の劣化は見られませんでした。

一方で、Gemini Embeddings 2はチューニングなしでもVertex tunedと同等以上の性能を示しました。また、チューニング済みEmbeddingモデルの推論にはVertex AI Endpointでの推論リソース管理が必要であり、当初期待していたserverless managed serviceとは違いました。

今回のまとめは、次の一文に尽きます。

Embedding tuningは効く。ただし、軽くはない。

RAGの精度向上が頭打ちになってきたとき、Embedding tuningは有力な選択肢になり得ます。ただし、まずは通常のRAG改善やreranking、query rewriting、最新Embeddingモデルの利用などの軽量な手法を試した上で、それでも顧客固有用語や業界用語の検索に課題が残る場合に検討するのが現実的だと思います。

今後は、Vertex AI以外のオープンなEmbeddingモデルやオンプレGPU、クラウドGPUインスタンスを使った運用も含めて、実用的な構成を模索していきたいと思います。

Multi Query Retrieverから2年後:テキストRAG改善のフェーズは変わったのか

はじめに

2024年3月に、HEROZ Tech Blogで「Multi Query Retrieverを用いたRAGの精度向上」に関する記事を公開しました。

techblog.heroz.jp

この記事では、Naive RAGに対してMulti Query Retrieverを適用することで、社内Wikiを対象とした評価において正答数が19/25から24/25に改善しました。当時としては、クエリの表現揺れや検索漏れをMulti Queryで補うことに明確な価値があり、Enhanced RAGの効果が分かりやすく出た検証だったと思います。

一方で、この記事は今でも継続的にアクセスされています。RAG改善への関心は今も高いのだと思いますが、最近いろいろなRAG改善手法を試していると、以前ほど分かりやすく精度が伸びない感覚もありました。

Query Rewrite、Multi Query、HyDE、ReRank、Agentic RAG、Router RAG、Hybrid Search、チャンク設計など、RAG改善としてよく挙げられる手法を試しても、平均スコアが大きく動かないことが増えています。

そこで今回は、2024年の記事から約2年経った現在、あらためて次の問いを検証してみました。

今でもEnhanced RAGやAgentic RAGは、Naive RAGに対して平均精度を大きく押し上げるのか?

結論から言うと、今回の検証では、手法間の平均スコアの差はかなり限定的でした。

もちろん、特定の条件では改善する手法もあります。特にAgentic RAGの一部は、データセットによってはNaive RAGを上回りました。しかし、Query Rewrite、Multi Query、HyDE、ReRank、ReAct、Adaptive RAG、Deep Agentを横並びで比較しても、「これを入れれば平均的に大きく改善する」と言える手法は見つかりませんでした。

そこで本記事では、今回の横並び比較の結果を紹介したうえで、近年のRAG関連研究も参照しながら、この結果をどう解釈すべきかを考えます。

最近の研究を見ても、RAG改善の論点は、単体のEnhanced RAG手法で平均精度を押し上げる方向だけではなく、LLMの性能向上による複雑なRAG改善の限界効用、Agentic RAGのコストと探索制御、Long Contextとの使い分け、検索結果を増やしすぎることの副作用といった方向に広がっています。

本記事では、社内検証の結果と関連研究を踏まえて、テキストRAG改善のフェーズがどう変わってきているのかを考察します。

今回比較したRAG手法

今回は、大きくEnhanced RAG系とAgentic RAG系に分けて比較しました。

Enhanced RAG

手法 概要
Naive 通常のベクトル検索 + 回答生成
ReRank 取得文書を質問への有用度で並び替える
Query Rewrite 質問を検索しやすいクエリに書き換える
Multi Query 複数の検索クエリを生成し、検索漏れを減らす
HyDE 検索用の仮想文書を生成して検索する

2024年の記事で扱ったMulti Query Retrieverも、このEnhanced RAG系の一種です。

Agentic RAG

手法 概要
Naive 通常のベクトル検索 + 回答生成
ReRank 参考値として比較
ReAct 検索ツールを使うReAct型エージェント
Adaptive RAG 検索や回答可否を適応的に判断するRAG
Deep Agent より複雑な探索を行うAgent構成

Agentic RAGは、単発の検索で回答するのではなく、必要に応じて検索クエリを変えたり、複数回探索したりする構成です。うまく機能すれば、単純なRAGでは拾えない根拠を見つけられる可能性があります。一方で、LLM呼び出し回数、トークン数、コスト、レイテンシが増えやすいという難しさもあります。

評価データセットと評価方法

評価には、以下の2つの日本語RAG評価データセットを使用しました。

データセット 問題数 特徴
Allganize RAG Dataset 207問 エンタープライズサーチ寄り
J-RAGBench 114問 難問寄り

Allganize RAG Datasetは、業務文書検索に近い性質を持つデータセットとして扱いました。一方でJ-RAGBenchは、より難問寄りのRAG評価として扱っています。

評価は、独自プロンプトによるLLM as a Judgeで行いました。JudgeにはClaude Sonnet 4.5を使用し、1〜5点の5段階でスコアリングしています。

なお、LLM as a Judgeによる評価には、評価モデル固有のバイアスやスコアのばらつきが含まれる可能性があります。そのため、本記事ではスコアの絶対値や0.01〜0.1程度の小さな差を厳密な優劣として扱うのではなく、手法間の相対的な傾向を見るための参考値として扱います。

また、今回のスコアは多くの手法で3点未満となっています。これは、RAG全体として十分に高品質な回答ができている、というよりも、今回の評価プロンプト・回答生成プロンプト・データセットの難易度を含めた結果です。本記事では、絶対スコアの高さよりも、同一条件で比較したときに手法間でどれくらい差が出るのかに注目します。

実験条件

本文中のスコアは、手法間の傾向を見やすくするため、チューニング前の横並び比較結果を掲載しています。各手法のプロンプトやAgent制御を一定程度整えた追加実験も行いましたが、全体の結論は大きく変わらなかったため、本文では割愛します。

再現性に関わる主な条件は以下です。

項目 設定
生成LLM gpt-5.4
Embeddingモデル text-embedding-3-small
チャンクサイズ 1200文字
チャンクoverlap 100文字
retrieve_k 基本は4。ReRank系のみ候補取得は12
top_k 4
ベクトルDB / 検索方式 Weaviate / LangChain WeaviateVectorStore.as_retriever によるベクトル類似検索
ReRank LLM rerank。同じ生成LLMをtemperature=0で使用し、候補文書indexをJSONで返す方式。cross encoderは未使用
Agentの最大探索回数 チューニング前比較では明示的な検索回数上限なし。LangGraphのrecursion_limit=25
評価回数 各質問・各手法につき1回評価。複数回平均ではない

結果:Enhanced RAGでは平均改善が限定的だった

まず、Enhanced RAGの結果です。

データセット Naive ReRank Query Rewrite Multi Query HyDE
Allganize RAG Dataset 2.80 2.79 2.72 2.82 2.80
J-RAGBench 2.48 2.57 2.48 2.50 2.42

Enhanced RAGの結果

Allganize RAG Datasetでは、Multi Queryが2.82で最も高く、Naiveの2.80に対して+0.02でした。J-RAGBenchでは、ReRankが2.57で最も高く、Naiveの2.48に対して+0.09でした。

どちらも改善はしていますが、5点満点の平均スコアとしてはかなり小さい差です。

ここで重要なのは、Multi QueryやReRankが無意味だった、ということではありません。これらの手法は、検索漏れや表現揺れ、検索結果のノイズが問題になるケースでは有効に働く可能性があります。

ただし、今回のようにデータセット全体の平均で見ると、Naive RAGを大きく押し上げる結果にはなりませんでした。

2024年の記事では、Multi Query Retrieverによる改善がかなり分かりやすく出ました。しかし今回の検証では、少なくとも平均スコアを見る限り、同じような大きな改善は確認できませんでした。

結果:Agentic RAGも安定した万能薬ではなかった

次に、Agentic RAGの結果です。

データセット Naive ReRank ReAct Adaptive RAG Deep Agent
Allganize RAG Dataset 2.77 2.83 2.79 3.13 2.88
J-RAGBench 2.51 2.55 2.52 2.28 2.58

Agentic RAGの結果

Allganize RAG Datasetでは、Adaptive RAGが3.13で最も高く、Naiveの2.77に対して+0.36でした。これは今回の結果の中では比較的大きな改善です。

一方で、J-RAGBenchではAdaptive RAGは2.28となり、Naiveの2.51を下回りました。J-RAGBenchで最も高かったのはDeep Agentの2.58ですが、Naiveとの差は+0.07にとどまりました。

つまり、Agentic RAGは特定の条件では有効に働く可能性があります。しかし、少なくとも今回の範囲では、データセットをまたいで安定して大きく改善する手法とは言えませんでした。

Naiveとの差分だけをまとめると、次のようになります。

データセット 系統 最良手法 Naive 最良スコア 差分
Allganize RAG Dataset Enhanced Multi Query 2.80 2.82 +0.02
J-RAGBench Enhanced ReRank 2.48 2.57 +0.09
Allganize RAG Dataset Agentic Adaptive RAG 2.77 3.13 +0.36
J-RAGBench Agentic Deep Agent 2.51 2.58 +0.07

Naiveとの差

Enhanced RAGでは、最良手法でもNaiveとの差は+0.02〜+0.09でした。一方、Agentic RAGではAllganize RAG DatasetのAdaptive RAGだけが+0.36と目立ちましたが、J-RAGBenchでは同様の改善は見られませんでした。

コストやレイテンシも含めると、さらに悩ましい結果になります。

データセット 手法 評価 時間(ms) LLM呼出回数 コスト(円)
Allganize RAG Dataset Naive 2.77 3019.4 1.0 1.40
Allganize RAG Dataset Adaptive RAG 3.13 8368.9 7.0 3.46
J-RAGBench Naive 2.51 1394.6 1.0 0.86
J-RAGBench Deep Agent 2.58 3158.8 2.1 5.05

コストとレイテンシ

Allganize RAG DatasetのAdaptive RAGは、Naiveに対して+0.36改善しています。一方で、時間は約2.8倍、LLM呼び出し回数は7倍、コストは約2.5倍です。

J-RAGBenchのDeep Agentは、Naiveに対して+0.07の改善に対して、コストは約5.9倍です。

この結果を見ると、Agentic RAGを常に使うというより、複数回探索が必要な質問や、回答可否判定が重要な質問に限定して使う方が自然だと感じました。

また、Adaptive RAGがAllganize RAG Datasetでは改善し、J-RAGBenchでは悪化した点も重要です。Allganize RAG Datasetはエンタープライズサーチ寄りであり、質問に対して「根拠があるか」「追加検索すべきか」「回答できないか」を判断するAdaptive RAGの制御が噛み合いやすかった可能性があります。一方で、J-RAGBenchのような難問寄りのデータセットでは、回答可否判定や追加検索判断が過剰に働き、必要な推論に進む前に回答を控えたり、余計な文脈を取り込んだりした可能性があります。

なお、本記事でのAdaptive RAGは、前回の記事で扱ったLangGraphの実装例を参考にした構成です。詳細な考え方は前回記事も参照してください。

この点はログ分析を深掘りしないと断定できませんが、Agentic RAGがタスク依存であることを示す重要な結果だと考えています。

関連研究から結果を読み解く

今回の検証では、Enhanced RAGやAgentic RAGを追加しても、平均スコアの改善は限定的でした。

この結果を解釈するうえで参考になるのが、近年のRAG関連研究です。ここでは、今回の結果と特に関係が深い4本に絞って紹介します。

強いLLM時代には、複雑なRAG改善の限界効用が下がる可能性がある

今回の結果に最も近いと感じたのが、2025年の “Revisiting Robust RAG: Do We Still Need Complex Robust Training in the Era of Powerful LLMs?” です。

この論文は、RAGがノイズ文書や無関係文書に弱いことを背景に、複雑なdocument selectionやadversarial trainingのようなrobust trainingが、強力なLLM時代でも必要なのかを検証しています。複数のモデルアーキテクチャ、モデルサイズ、データセットで評価した結果、モデルが強力になるほど、複雑なrobust RAG trainingによる性能向上は大きく低下する傾向が報告されています。

これは、今回の「Naive RAGにさまざまな手法を足しても平均スコアが大きく動かなかった」という結果とかなり整合的です。

もちろん、この論文が扱っているのはrobust trainingであり、今回のQuery RewriteやMulti Queryそのものではありません。しかし、より強いLLMでは複雑なRAG周辺手法の限界効用が小さくなる、という大きな方向性は、今回の実験結果を解釈するうえで重要な補助線になります。

Agentic RAGは、性能だけでなくコストとのトレードオフで見る必要がある

Agentic RAGについては、以前の記事 “Is Agentic RAG worth it? An experimental comparison of RAG approaches” を紹介しました。

この論文では、Enhanced RAGとAgentic RAGを複数シナリオ・複数観点で経験的に比較し、どちらが常に優れているというより、性能とコストのトレードオフを踏まえてRAG設計を選ぶ必要があると整理しています。Agentic RAGはLLMがどの行動をいつ行うかを判断する柔軟性を持つ一方で、その分、計算資源やコストの問題が生じます。

今回の結果でも、Agentic RAGはAllganize RAG Datasetでは改善した一方で、J-RAGBenchでは安定した改善にはなりませんでした。また、改善したケースでもLLM呼び出し回数やコストは増えています。

この意味で、Agentic RAGは「導入すれば精度が上がる万能手法」というより、タスクや失敗モード、コスト制約に応じて使うべき構成だと考えています。

検索結果やコンテキストは、増やせばよいわけではない

Multi QueryやAgentic RAGは、検索回数や投入文脈を増やす方向に働きやすい手法です。しかし、検索結果やコンテキストは増やせば増やすほどよいわけではありません。

“In Defense of RAG in the Era of Long-Context Language Models” では、Long Context LLMの時代におけるRAGの価値を再検討し、OP-RAGという手法を提案しています。この論文では、取得チャンク数を増やすと回答品質が一度上がってから下がる、逆U字型の挙動が報告されています。つまり、適切な取得量にはスイートスポットがあり、文脈を増やしすぎると品質が下がりうるということです。

これは、今回の結果を考えるうえでも重要です。Multi QueryやAgentic RAGによって取得文書が増えても、それが必要な根拠であれば有効ですが、不要な文脈やノイズが増えるだけであれば、改善にはつながりません。

RAGかLong Contextかの選択も、条件依存になっている

2025年のLaRAは、RAGとLong Context LLMを体系的に比較するベンチマークです。2,326のテストケース、4つの実用QAカテゴリ、3種類の長文テキストを対象に、7つのOSSモデルと4つの商用モデルを評価しています。その結果、RAGとLong Contextのどちらが適しているかは、モデルサイズ、長文処理能力、context length、タスクタイプ、retrieved chunkの性質などに依存すると報告されています。

つまり、外部知識を扱う方式そのものも、単純な優劣ではなく条件依存です。

これらの研究を合わせると、最近のRAG研究は「単体手法を足せば平均的に伸びる」というより、「タスクや失敗モードに応じて、検索・文脈・Agent化・Long Context利用の度合いを選ぶ」方向に進んでいるように見えます。

なぜ差がつきにくくなったのか

ここからは、今回の実験結果と関連研究を踏まえた考察です。

Naive RAGのベースラインが上がっている可能性

一番大きいのは、Naive RAGのベースラインが以前より上がっている可能性です。

2024年頃は、検索クエリと文書中の表現が少しずれるだけで検索漏れが起きたり、取得文書にノイズが混じるとLLMがうまく回答できなかったりしました。そのため、Multi Queryのように検索クエリを増やすだけでも、平均精度が分かりやすく改善する余地がありました。

しかし現在は、EmbeddingモデルやLLMの性能向上により、単純なベクトル検索でも必要な文書を拾えるケースが増えている可能性があります。また、LLMの文脈読解能力が上がったことで、検索結果に多少ノイズが含まれていても、回答に必要な部分を抽出できるケースも増えているのではないかと考えています。

その結果、Query RewriteやMulti Queryを追加しても、「もともと解ける問題を、より高コストに解いているだけ」になりやすいのかもしれません。

検索や文脈を増やすことが、常に改善につながるわけではない

Multi Query、HyDE、Agentic RAGは、いずれも検索や文脈を増やす方向に働きやすい手法です。

しかし、関連研究でも示唆されているように、文脈は増やせば増やすほどよいわけではありません。必要な根拠が増える場合は有効ですが、不要な文脈が増えると、LLMの焦点がぼやけたり、矛盾した情報が混ざったり、コストだけが増えたりします。

今回の結果でも、Enhanced RAGやAgentic RAGを足したからといって、平均スコアが安定して伸びるわけではありませんでした。

これは、RAG改善が「検索を増やす」だけではなく、「必要な情報だけを、必要以上にノイズを増やさず渡す」問題になっていることを示しているように思います。

残る課題は平均改善ではなく、失敗モード別対応になっている

今回の検証と最近の研究動向を合わせて見ると、テキストRAGの改善は、平均点を上げる汎用手法の追加から、失敗モード別の対応へ移っているように見えます。

たとえば、型番や価格、日付のような厳密一致が重要なケースでは、ベクトル検索よりもキーワード検索やmetadata、DB検索が重要になります。

表やPDFレイアウトに情報が埋まっているケースでは、テキストRAGではなくOCR、table parser、マルチモーダルRAGが必要になります。

複数文書の関係性やmulti-hopが重要なケースでは、GraphRAGやAgentic RAGのような構成が効く可能性があります。

一方で、単純なFAQや文書検索では、Naive RAGで十分な場合もあります。

つまり、「どのRAG手法が最強か」ではなく、「どの失敗モードに、どの処方を当てるか」が重要になってきているのだと思います。

まとめ:RAG改善は「手法追加」から「失敗モード別対応」へ

今回、2024年のMulti Query Retriever記事から約2年後の再検証として、Enhanced RAGとAgentic RAGを横並びで比較しました。

Allganize RAG DatasetとJ-RAGBenchで評価したところ、Query Rewrite、Multi Query、HyDE、ReRankといったEnhanced RAGは、Naive RAGに対して平均スコアを大きく押し上げる結果にはなりませんでした。

Agentic RAGについても、Allganize RAG DatasetではAdaptive RAGが改善した一方で、J-RAGBenchでは安定した改善は見られませんでした。少なくとも今回の範囲では、単にAgent化すればRAGが強くなる、とは言えなさそうです。

関連研究を見ても、強力なLLM時代における複雑なRAG改善の限界効用、Agentic RAGの性能とコストのトレードオフ、取得チャンク数のスイートスポット、RAGとLong Contextの条件依存な使い分けが議論されています。今回の結果は、そうした流れとも整合的に見えます。

実務で見るなら、全質問に同じEnhanced RAGを常時適用するより、失敗モードごとに処方を選ぶ方が自然です。

失敗モード 対応候補
検索意図が曖昧 Query Rewrite
表現揺れ・検索漏れ Multi Query / HyDE
取得文書にノイズが多い ReRank / Context Compression
multi-hop・関係性が重要 GraphRAG / Agentic RAG
型番・価格・日付が重要 Keyword Search / Metadata / DB検索
PDF・表・図に情報がある OCR / Table Parser / Multimodal RAG
回答可否判定が重要 Adaptive RAG / Abstention設計

テキストRAGが終わったわけではありません。 ただし、汎用手法を足して平均精度を押し上げるフェーズから、失敗モードを見極めて適切な処方を当てるフェーズへ移っている。今回の検証は、その変化を実感する結果になりました。